インフルエンザ流行予測モデル TERN
TERN(Temporal Erase-then-delta Recurrent Network)は、週次のインフルエンザ患者数を数週間先まで予測するモデルです。株式会社エル・ティー・エスとの共同研究として開発し、論文をarXivで公開しています。日本の47都道府県と米国の2つの公開ベンチマークで、既存の感染症予測モデルや汎用の時系列予測モデルを上回る精度を達成しました。コードと設定も公開しています。
背景
インフルエンザの流行予測は、ワクチンの配分や注意報・警報の判断を支える、公衆衛生の基礎的な入力です。しかし、この予測は簡単ではありません。地域ごとに使えるデータは数シーズン分しかなく、流行の山は年ごとに時期も高さも変わります。さらに、流行が立ち上がる局面で役立つ情報は、山を越えたあとには逆に予測を誤らせます。一方で、前のシーズンの形は1年を通じて参考になり続けます。
既存の感染症向けグラフモデルや汎用の時系列予測モデルは、直近の固定長の窓だけを読み、過去の情報をすべて同じ重みで扱います。そのため、以前のシーズンを活かすことも、流行の局面が変わったときに古くなった関係を捨てることもできません。
取り組み
TERNの中核は、「何を忘れ、何を残すか」を流行の局面に応じて制御する記憶の仕組みです。
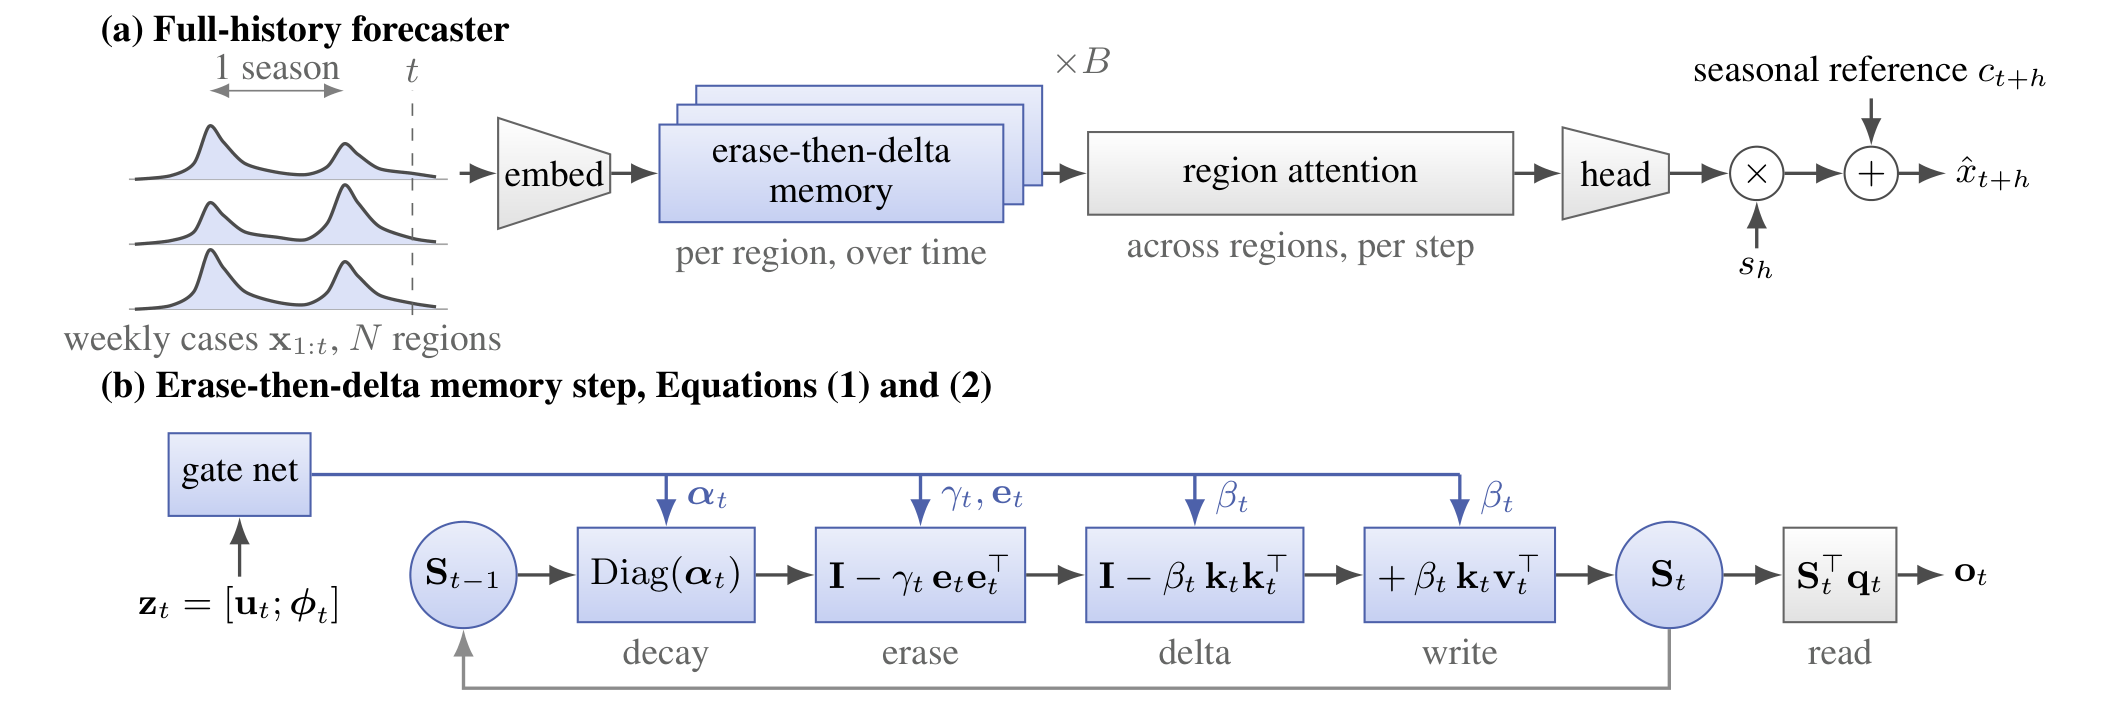
TERNの構成。(a) 各地域の週次患者数を時間方向に読む記憶のブロックと、地域をまたぐ注意、季節の参照値からなる予測器。(b) 記憶の1ステップ。局面の特徴を読んだゲートが、減衰・消去・デルタ則・書き込みの強さと消去のアドレスを決める。青が提案した記憶、灰色が標準的な部品(Nagashima and Funayama [1], Figure 1 より引用)
局面に応じて消して書く記憶。 モデルの内部に、デルタ則で更新される高速な重みの記憶を持ちます。この記憶はチャネルごとに異なる速さで減衰し、学習したアドレスに沿って古い内容を消してから新しい内容を書き込みます。消す強さと書く強さは、患者数の増減や前週からの変化といった局所的な流行局面の特徴で決まります。流行の立ち上がりで有効だった関係を、ピークを過ぎたら捨てられるようにした設計です。
季節の参照と、運用中の適応。 記憶だけで1年周期を学ぶのではなく、前シーズンの同時期の値や平年値を明示的な参照として与え、その重みも学習します。さらに、新しい観測が入るたびにモデルを更新し、季節的な単純予測と最適な比率で混ぜる運用中の適応を組み合わせました。
結果
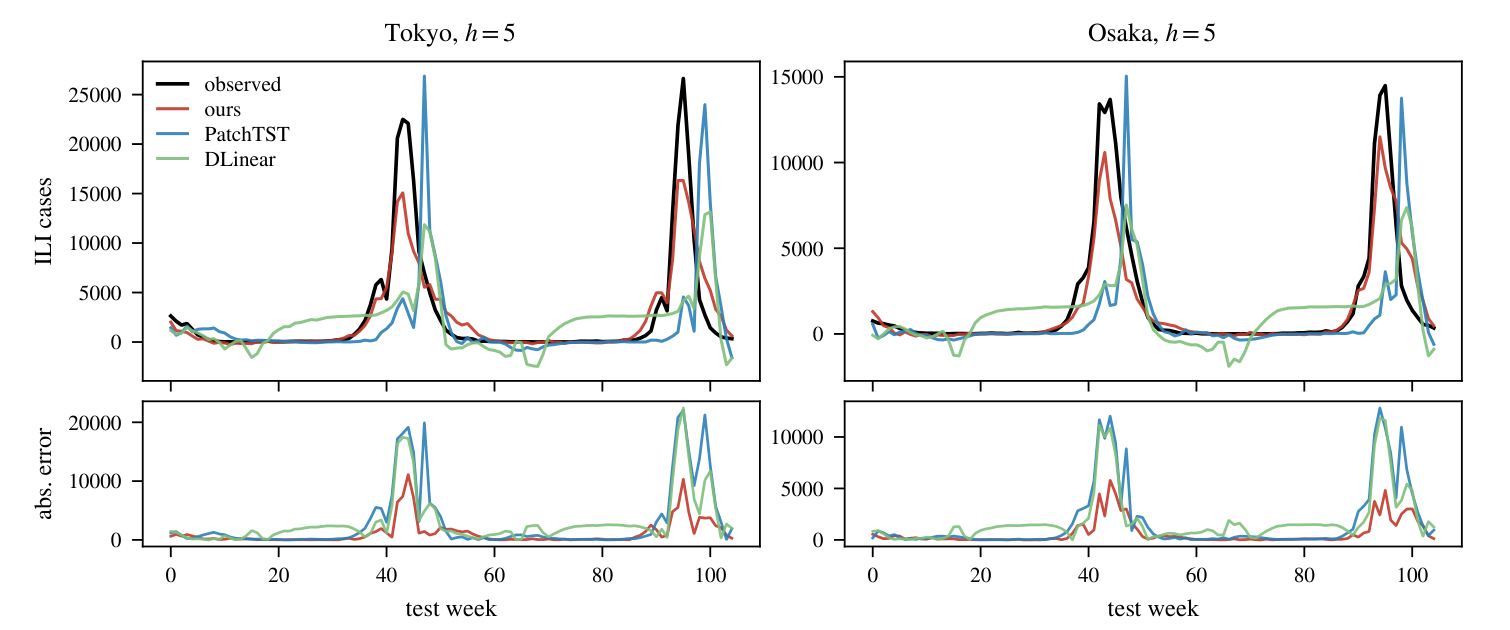
東京と大阪における5週間先の予測(上段)と絶対誤差(下段)。TERNは4つの流行の山をいずれも観測の1週間以内に置いたのに対し、比較したPatchTSTとDLinearは3〜5週遅れた(Nagashima and Funayama [1], Figure 2 より引用)
評価には感染症予測の研究で標準的に使われる3つの公開ベンチマークを用いました。日本の47都道府県(2012〜2019年、348週)、米国の10の保健行政地域(2002〜2017年、785週)、米国の49州(2010〜2017年、360週)で、3・5・10・15週先を予測します。比較対象は、季節的な単純予測(前年同週の値、平年値)、感染症向けのグラフモデル(Cola-GNN、EpiGNN)、汎用の時系列予測モデル(DLinear、PatchTST、iTransformer、TimeMixer、TimesNet)、ゼロショットの時系列基盤モデル(Chronos-2、TimesFM-3)です。
| 手法 | 日本 RMSE / PCC | 米国地域 RMSE / PCC | 米国州 RMSE / PCC |
|---|---|---|---|
| 前年同週の値 | 839 / 0.913 | 876 / 0.802 | 307 / 0.764 |
| 平年値 | 1030 / 0.876 | 727 / 0.862 | 265 / 0.812 |
| Cola-GNN | 1254 / 0.839 | 957 / 0.775 | 212 / 0.877 |
| EpiGNN | 1234 / 0.831 | 852 / 0.799 | 200 / 0.892 |
| DLinear | 1731 / 0.543 | 1013 / 0.695 | 249 / 0.833 |
| PatchTST | 2026 / 0.185 | 1077 / 0.618 | 251 / 0.818 |
| iTransformer | 2039 / 0.318 | 991 / 0.687 | 220 / 0.865 |
| TimeMixer | 1998 / 0.216 | 1109 / 0.599 | 267 / 0.790 |
| TimesNet | 1965 / 0.284 | 1046 / 0.677 | 288 / 0.776 |
| Chronos-2 | 1314 / 0.776 | 698※ / 0.877※ | 207※ / 0.883※ |
| TimesFM-3 | 1498 / 0.683 | 340※ / 0.972※ | 139※ / 0.949※ |
| TERN(20週の窓) | 1145 / 0.857 | 885 / 0.775 | 206 / 0.885 |
| TERN(全履歴) | 838 / 0.926 | 698 / 0.872 | 199 / 0.898 |
各セルは RMSE(二乗平均平方根誤差。低いほど良い)/ PCC(相関係数。高いほど良い)で、いずれも4つの予測期間の平均です。「日本」は47都道府県、「米国地域」は10の保健行政地域、「米国州」は49州のデータセットを指します。太字が各列の最良値で、TERN(全履歴)は11の比較手法に対して、3つのデータセット・6つの指標のすべてで最良でした。※を付けた値は、米国のデータを事前学習に含む基盤モデルのもので、評価期間を学習済みのため参考値です。
結果からは、感染症予測の難しさもあらためて見えました。前年同週の値をそのまま使う単純な予測は、長い予測期間では公表されている感染症向けグラフモデルをすべて上回っていました。TERNは日本でこの単純予測と同等のRMSEに達し、相関では上回りました。また、記憶の仕組み以外の条件をすべて揃えた比較で、提案した記憶は一般的なソフトマックス注意に対してRMSEを3〜22%改善しており、精度の向上が記憶そのものによることを確かめています。
位置づけと今後
評価はインフルエンザの3つのベンチマークに限られており、他の感染症や入院患者数のような指標への適用は今後の課題です。確率的な予測の出力も予定しています。感染症の流行や病床需要のように、季節性と局面の変化が重なる時系列を扱う技術として、当社の医療・ヘルスケア分野の取り組みの一つです。