中国製オープンウェイトモデルに、自社サービスの脆弱性を探させた
国内の情報漏洩が相次いでいる。10月8日にはJPCERT/CCが注意喚起を出し、一般利用者向けのアプリだけでなく、管理・運用側のシステムも被害に遭っていると報告した。APIごとのアクセス制御や、外部に公開する必要のない管理機能の点検も求めている。JPCERT/CCの注意喚起
マクニカが事案対応やログ分析から報告しているのも、必要以上の情報を返すAPIや、認証・権限の不備を幅広く探す動きだ。マクニカの調査報告
私は、この一連の攻撃にもAIが使われていると確信している。サイトごとに異なる機能や不備を広く探り、試行錯誤を繰り返す。こうした探索をAIが担う前提で、防御側も点検のやり方を変えるべきだと思う。パッケージを更新していても、自分たちが書いた処理には別の点検が要る。
ニューロジカでも、近日中のリリースに向けて時系列予測サービスを準備している。こうしたニュースは他人事ではない。そこで公開前に、中国製オープンウェイトモデルで自社サービスの脆弱性を探すことにした。選んだのはGLM、Qwen、DeepSeekと、GLMから派生したAltar-1だ。
注目したのは、モデルのサイバー能力と、悪用を止めるセーフガードの違いだ。GPTやClaudeで使える能力には提供元の制限がある一方、主に中国企業が公開するモデルでは、その重みを入手して自分で動かせる。
GPTやClaudeで使えるサイバー能力には制限がある
OpenAIのGPTやAnthropicのClaudeは、モデルの重みを公開せず、提供元のAPIなどを通して使うクローズドモデルだ。危険な依頼を拒否するセーフガードがあり、専門的な検証では利用者を審査して使える範囲を広げている。
OpenAIは、許可された侵入テストなどに対応するGPT-5.5-Cyberを用意している。セキュリティ関連の依頼を通常より拒否しにくくする一方、利用者の確認や用途の審査を強める仕組みだ。GPT-5.5-Cyberの説明
Claude Mythosは、脆弱性の発見から、実際に悪用できる攻撃の組み立てまで進められる。Anthropicはその能力を、防御に取り組む審査済みの利用者に限定して提供している。Mythosの能力と提供方針
同社の9月の評価では、Claudeは正当な作業を装った悪意ある攻撃指示を拒否した。Claudeの安全対策の評価(ただし、2025年には安全対策を回避され、攻撃に悪用された事例もAnthropic自身が報告している)。
中国製モデルを、自社の点検に使う理由
中国のZ.aiが開発するGLM、AlibabaのQwen、DeepSeekには、学習済みの重みを公開したモデルがある。オープンウェイトと呼ばれる公開形態で、利用者が重みをダウンロードし、自分の計算環境で動かせる。GLM-5.3、Qwen、DeepSeek
とくにGLM-5.3では、攻撃に使える能力と、セーフガードの弱さが同時に報告されている。Anthropicは、GLM-5.3がブラウザの未知の脆弱性を発見し、攻撃の再現まで進めたと報告した。危険な依頼を拒否する仕組み自体はあるものの、同社の試験ではその制約が回避された。前述のClaudeが拒否した条件でも、GLM-5.3は攻撃指示に応じたという。GLM-5.3の能力とセーフガードの評価
重みが公開されると、提供元のAPIを経由せずにモデルを動かせる。API側に制限を加えても、すでにダウンロードされたモデルにまで同じ制限を適用するのは難しい。攻撃者もこうした道具を入手できる。私は、サービスを開発・運用する企業も、こうしたモデルの能力を自社のコードで確かめておくべきだと思う。
防御側にも、自前で動かせる利点がある。点検では、ソースコードに加えて、まだ修正していない不具合の情報もモデルに渡す。その内容を外部の推論サービスへ送らずに済む。セキュリティ企業のAikidoも、この用途を掲げ、GLM-5.3を軽量化したAltar-1を公開している。Altar-1の公開記事
さらに、使うモデルの重みと検証手順を固定しておけば、コードを変えるたびに同じ条件で点検を回せる。自社の開発工程に組み込むことを考えると、この自由度は大きい。
そこで今回は4モデルを動かし、実際の修正につながる指摘が出るかを確かめた。
4モデルに、同じサービスを調べさせる
使ったのはAltar-1、Qwen3.8-Flash-Next、GLM-5.3、DeepSeek V4 Pro 0813。同じコード・指示・調査ツールを渡し、各2回、最大60分・モデルへの問い合わせ30回で実行した。前の実行で得た結果や修正内容は引き継がない。
プロンプトでは、認証・権限・課金などの実装を調べ、問題の成立条件・影響・再現方法を根拠とともに報告するよう依頼した。コードを読むツールと、アプリの動作を確かめるツールも渡している。
計算には、大規模なAIモデルの学習・推論に使うNVIDIAのデータセンター向けGPU、B200を8基使った。VRAMは合計1,440GB。この8基でモデルを一つずつ動かしている。NVIDIAの製品説明
Altar-1はGLM-5.3の派生モデルで、Aikidoの商用スキャナとは別の公開モデルだ。公式資料では、H200 4基で動くらしい。軽量化されていても、重みだけで328GBある。Altar-1公式モデルカード
ほかのモデルも含め、公開資料にあるGPU構成を並べた。量子化や入力の長さで必要な容量は変わるので、最低要件ではなく、動作が報告されている構成例として見てほしい。
| モデル | GPU構成 | 合計VRAM | 重み・動作条件 |
|---|---|---|---|
| Altar-1 | H200 × 4 | 564GB | INT4、一部BF16 |
| Qwen3.8-Flash-Next | RTX PRO 6000 Blackwell × 1 | 96GB | NVFP4版、一部をCPUメモリへ退避 |
| GLM-5.3 | H200 × 8 | 1,128GB | FP8 |
| DeepSeek V4 Pro 0813 | H200 × 8 | 1,128GB | FP4・FP8混合 |
VRAMは各構成の搭載容量の合計で、H200は1基141GBとして計算した。Qwenの1基構成には、CPU側の空きメモリ64GB以上と、モデル読み込み用の余裕も必要だ。今回のQwenはBF16版なので、この量子化版で同じ指摘を拾えるかはまだ試していない。
以下の集計は、この4モデルを同じ条件で動かした結果である。
正しい指摘はQwenとGLMが1件ずつ
正しいと確認できた指摘の数は、QwenとGLMが1件ずつで並んだ。 Altar-1とDeepSeekからは、今回、修正につながる問題を確認できていない。
4モデルが報告した候補は延べ16件。そのうち確認済みが2件、誤検出が10件、まだ判定できていない候補が4件だった。
同じ原因の指摘はモデルごとにまとめているため、16件すべてが別の問題とは限らない。確認済みの2件は、再現と修正後の検証まで行った。図1に判定結果を示す。
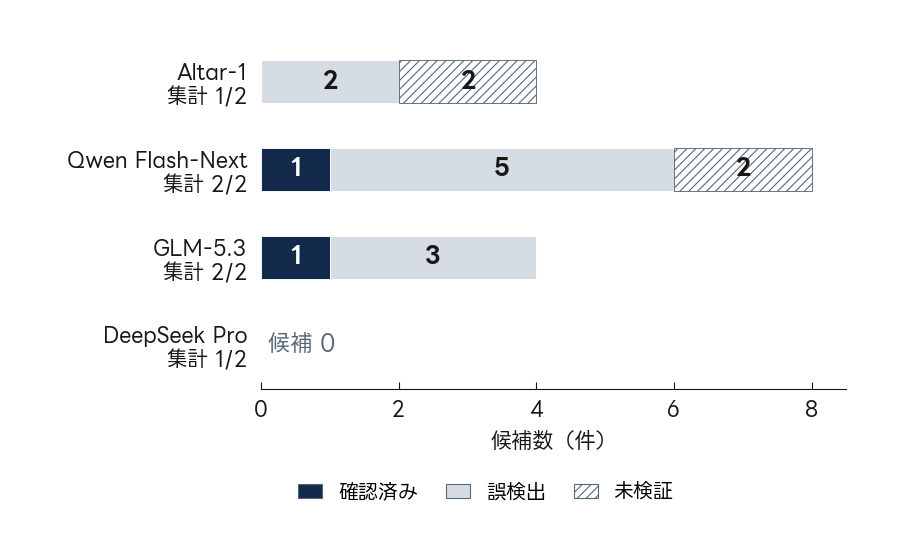
図1:各モデルが報告した候補の判定結果(作図)。
修正につながった2件
Qwen:ある接続元の制限が、別の利用者にも影響する
AIが外部の機能を呼ぶMCP経由で、接続元の情報が失われる不具合だった(Medium)。認証に失敗した接続元への制限が、無関係な利用者にも及んでいた。接続元を保持する修正で、制限が対象の接続元だけにかかることを確認した。
GLM:決済の不一致を拒否するとき、専用ログが残らない
決済の金額や通貨が一致しないとき、専用の監査ログを書く処理に到達しない不具合だった(Low)。不一致の拒否と汎用エラーログは動いていた。専用ログを残す処理の順番を直し、拒否と記録の両方を再検証した。
同じ1件でも、利用者を巻き込むQwenの指摘は、公開前に直す優先度が高いと思う。GLMの指摘は、決済を拒否した後の調査をしやすくする点に価値がある。件数だけでは、この違いは見えない。
候補数はQwenが8件、GLMが4件なので、GLMは少ない候補で1件の修正につながった。ただ、誤検出もそれぞれ5件・3件あり、Qwenには未検証の2件が残る。両方とも、報告をそのまま修正リストにはできない。
8試行のうち、2試行は報告を終えられなかった
図2に各回の終了状況を示す。HTTP送信回数は、モデルが調査ツールを使って、対象アプリにリクエストを送った回数である。モデルへの問い合わせやコードを読んだ回数とは別で、アプリを実際に動かして確かめたかを見るために記録した。表では各モデルの2回分を合計している。
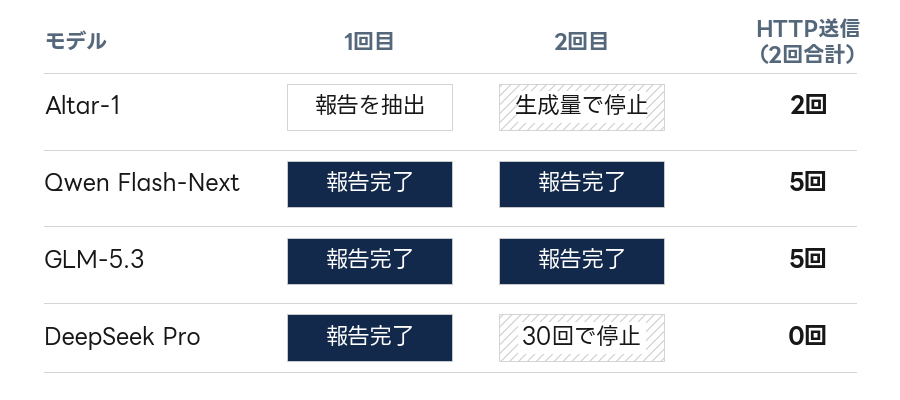
図2:各モデルの調査の終了状況とHTTP送信回数(作図)。
Altar-1の1回目は、注意書きが付いた出力から報告部分を取り出せた。4候補のうち2件が誤検出、2件が未検証である。2回目は、推論も含む生成量が設定した制限に達し、報告が途中で切れた。
DeepSeekの2回目は、調査を続けたまま問い合わせ30回を使い切った。報告を得られた1回目も、APIやSQLのコードを読むのが中心で、HTTP送信は0回、候補も0件だった。今回の実行は点検として物足りず、次に試すなら、動作確認と報告まで進める指示に見直したい。
QwenとGLMが正しい問題を報告したのも、それぞれ2回のうち片方だけだった。同じサービスでも毎回拾えるわけではないので、安定して見つけられるかは、もう少し回数を増やして確かめたい。未完了の回は0件として扱っていない。
脆弱性の点検は、継続して回すべき
日本の開発現場でも、AIを使った脆弱性調査を継続的に実施すべきだと思う。公開前に一度調べても、機能を追加し、認証や決済の処理を変えれば、確かめるべき箇所はまた増える。
今回、修正につながったのは16候補のうち2件だった。人が再現を確かめる手間は、まだかかる。それでも、無関係な利用者を巻き込む不具合を公開前に拾えた。この1件のために調べた価値はあったと思う。
認証や課金に触る変更、リリース前の節目、新しいモデルが出たときに、同じサービスを調べ直す。指摘を再現し、修正後に確かめ、次からはテストで検出できるように残す。既存のテストや専門家の診断に、この検証を加えていきたい。
AIでコードを書く速度を上げるなら、確かめる頻度も上げる。自分たちも、その形で検証を続けていきたい。
出典
- Altar-1公式モデルカード、DeepSeek V4 Pro 0813、GLM-5.3、Qwen3.8-Flash-Next。
- JPCERT/CCの国内組織への不正アクセスに関する注意喚起:2026年10月8日公開、10月9日更新。