不規則時系列モデルの系譜:GRU-D・Neural ODE・mTANから最新まで
「欠損は埋めてからモデルに入れれば済むのでは」
そう思う人もいるかもしれない。時系列分析では、データの質が結果を大きく左右する。しかし、実際の時系列データには欠損や観測間隔のばらつきが頻繁に現れる。センサーデータでは通信断によって値が抜け、医療データでは検査項目ごとに測定タイミングが異なる。
では、時系列データに欠損があったとき、どう扱えばよいのだろうか。まず考えられるのは、直前の値を使う、平均値で埋める、前後の値から補間するといった方法である。しかし、単に欠損値を埋めるだけで十分なのだろうか。「値が観測されなかった」という事実や、「最後の観測からどれだけ時間が経ったか」も、予測に役立つ情報かもしれない。
こうした欠損や不規則な観測間隔を含む時系列に対して、モデルはさまざまな方法で発展してきた。本記事では、特に次の流れを取り上げる。
- GRU-D [1](2018年):欠損の有無と経過時間をRNNの内部で扱い、時間とともに古い情報を減衰させる
- Neural ODE [2](2018年):状態の変化を、単純な減衰ではなく連続時間のダイナミクスとして学習する
- mTAN [4](2021年):観測時刻そのものをAttentionに組み込み、不規則な時刻の関係を学習する
- ISTS-PLM [5](2025年):不規則時系列を事前学習済みモデルへ拡張する
この流れを追うと、不規則時系列の研究が単なる「欠損値をどう埋めるか」から、「不規則な時間をモデルの中でどう表現するか」へと広がってきたことが見えてくる。
GRU-D:欠損と経過時間をモデル内部で扱う
不規則時系列を扱ううえで重要な転換点となったのが、2018年に発表されたGRU-D [1] である。
従来は、欠損値を平均値や直前の観測値で補完し、その後にRNNへ入力する方法がよく用いられていた。しかし、補完後の値だけをRNNへ入力する場合、その値が実際に観測されたものなのか、欠損を補うために生成されたものなのかをモデルは判断できない。また、前回の観測から1分後に補完された値と10時間後に補完された値が同じであれば、モデルには同じ値として与えられる。その結果、最後の観測から長い時間が経過した古い値であっても、直近の観測に基づく値と同じように扱ってしまう可能性がある。
GRU-Dでは、これらの問題に対応するために、ある時刻 t での入力値 xt に加えて、値が観測されたかどうかを表すmask mt と、最後の観測からの経過時間 δt を利用する。
mask mt は、各値が実際に観測されたかどうかを表す情報であり、観測されていれば1、欠損していれば0として表現する。これをGRUの計算に直接与えることで、モデルは実際の観測値と補完値を区別することができる。
一方、経過時間 δt は、最後に値が観測されてからどれだけ時間が経ったかを表す。GRU-Dでは、この経過時間 δt に応じて学習可能な減衰(Decay)を適用する。入力値が欠損している場合には、最後の観測から時間が経つほど、最後に観測された値を利用する割合を小さくし、その変数の平均値に近づける。通常のGRUとGRU-Dの構造を並べたのが下の図1である。
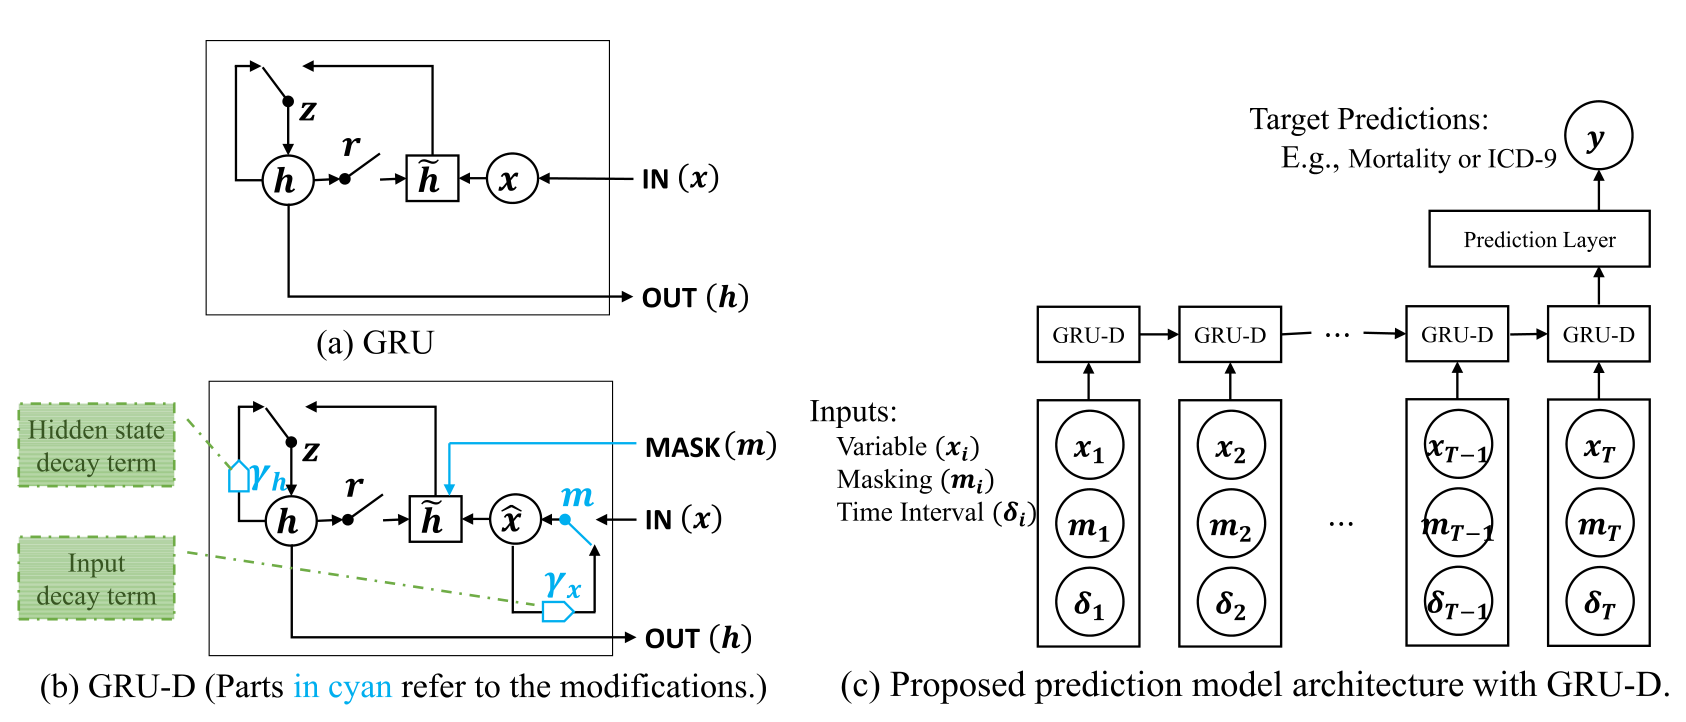
図1: 通常のGRUとGRU-Dの構造、およびGRU-Dを用いた予測モデル。(a)はGRU、(b)はGRU-Dの構造を示す。GRU-Dでは、入力値に対する減衰 γx と隠れ状態(hidden state)に対する減衰 γh が追加されている。入力値が欠損している場合には、γx によって最後の観測値を経過時間に応じてその変数の平均値へ近づける。一方、γh は隠れ状態に適用され、時間が経つほど過去の状態の影響を弱める。また、mask m をGRU内部の計算に与えることで、観測の有無そのものも利用する。(c)は、各時刻 i の観測値 xi、mask mi、経過時間 δi を用いて予測を行う全体の流れを示している(Che et al. [1], Figure 3より引用)
つまりGRU-Dでは、欠損を単に補完してからモデルへ渡すのではなく、「観測されたか」と「どれだけ時間が経ったか」まで含めて時系列を扱う ようになったのである。
ただし、GRU-Dでは、経過時間の影響を主に減衰(Decay)として表現する。最後の観測から時間が経つほど、欠損時の入力値については最後に観測された値を変数の平均値へ近づけ、隠れ状態については過去の状態の影響を弱める。
この方法では、観測されていない時間の長さをモデルに反映できる一方で、観測間の状態変化そのものを学習するわけではない。たとえば、状態が時間とともに増加したり、減少したり、複雑に変化したりする過程そのものをモデル化するものではない。
では、観測と観測の間に状態がどのように変化するのか、その変化自体を学習することはできないだろうか。この考え方につながるのが、Neural ODEを用いた連続時間モデルである。
Neural ODE:状態の変化を連続時間で表現する
GRU-Dでは、最後の観測からの経過時間を利用し、古い情報の影響を減衰させていた。2018年に発表されたNeural ODE [2] では、時間に対する考え方がさらに一歩進む。
Neural ODEの基本的な発想は、ある時刻の状態から次の時刻の状態を一度の更新で求めるのではなく、状態が時間とともにどのように変化するのかをニューラルネットワークで学習すること である。その基本形は、
dh(t) / dt = fθ(h(t), t)
と表される。ここで h(t) は時刻 t における状態、fθ(·) は、現在の状態と時刻から状態の変化率を求めるニューラルネットワークである。Neural ODEでは、fθ(·) が求める変化率を時間に沿って積み重ねることで、任意の時刻における状態を求める。
GRU-Dが経過時間に応じて過去の情報を減衰させるのに対し、Neural ODEでは、観測と観測の間で状態がどのように変化するのか自体を学習する。この発想を不規則時系列へ取り入れた代表例が、2019年に発表されたODE-RNNやLatent ODE [3] である。
ODE-RNN:観測がない時間をODEで進める
ODE-RNN [3] では、観測と観測の間でNeural ODEによって隠れ状態を連続的に発展させ、新しい観測が得られた時点でRNNによって状態を更新する。
つまり、観測されていない時間を単なる空白として扱うのではなく、観測がない間も隠れ状態を時間とともに変化させる。ODE-RNNでは、その観測間の変化をあらかじめ指数的な減衰などの形に固定するのではなく、ニューラルネットワークによって学習する。各モデルで観測間の隠れ状態がどう変化するかを比べたのが下の図2である。
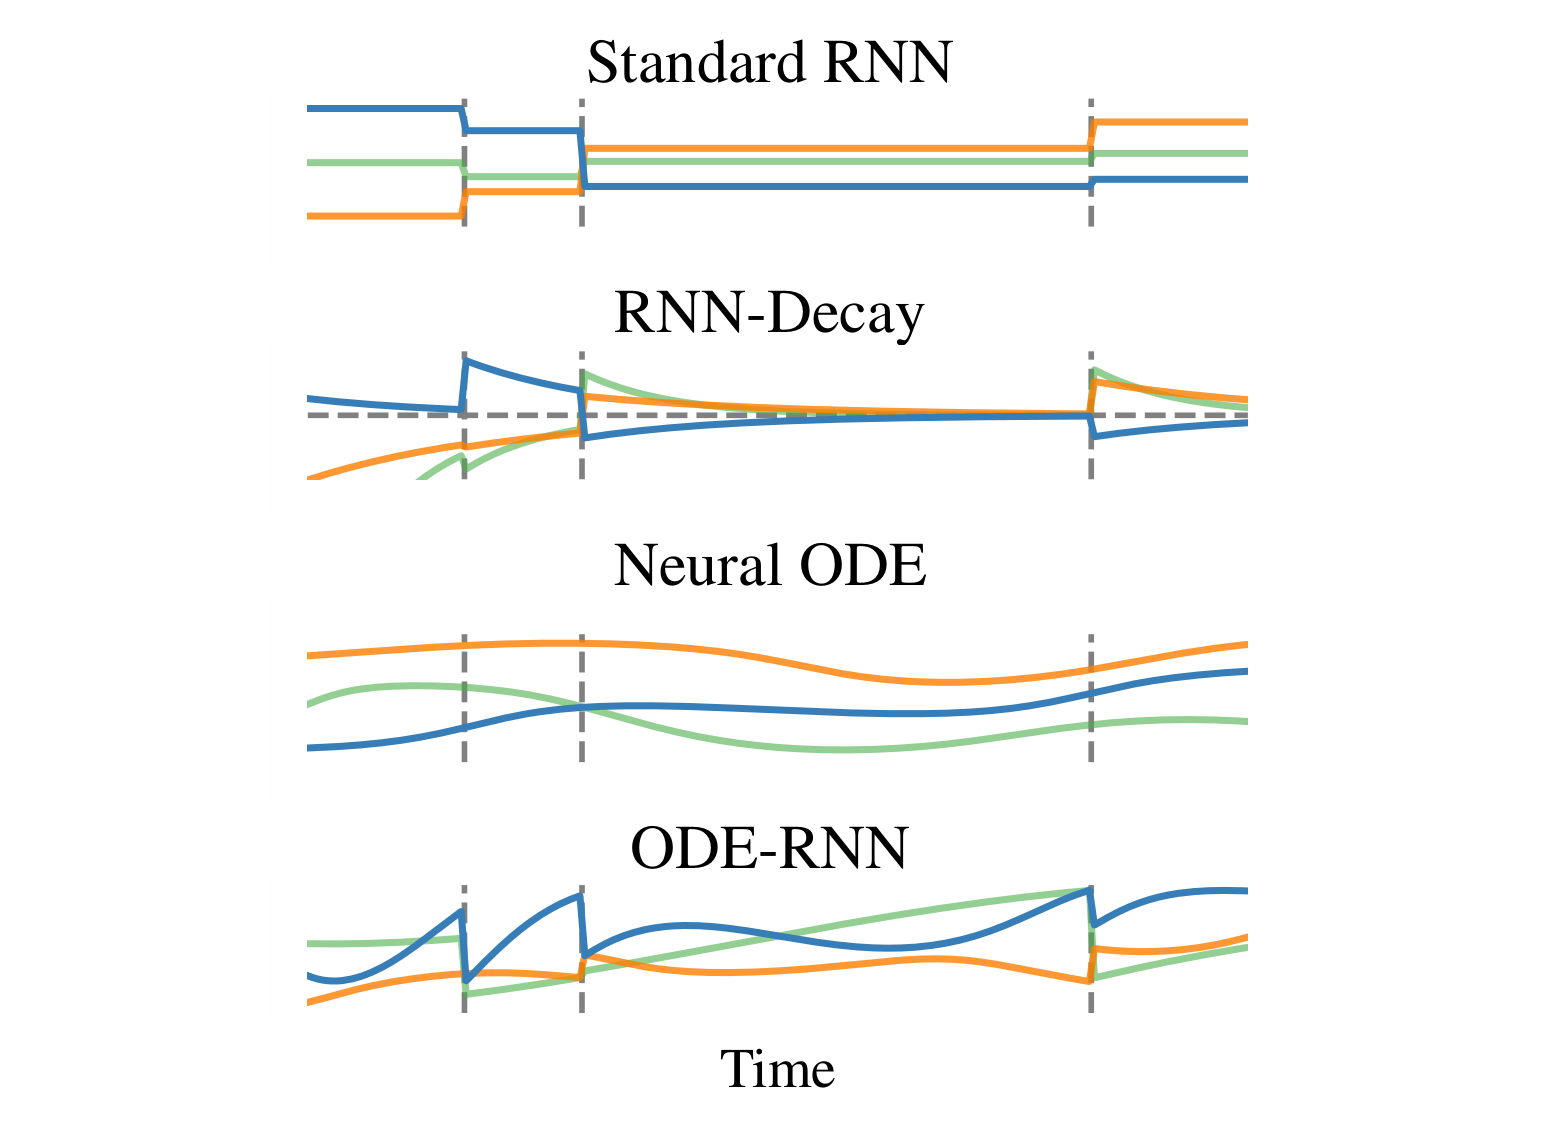
図2: 各モデルにおける観測間の隠れ状態の変化。縦の破線は観測時刻を表す。Standard RNNでは、観測が得られた時点で隠れ状態を更新し、観測間では状態を更新しない。RNN-Decayでは、観測間の隠れ状態を時間とともに指数的に減衰させる。GRU-Dでも、経過時間に応じて隠れ状態を減衰させる仕組みが用いられている。Neural ODEでは、状態の変化そのものをニューラルネットワークで学習し、連続的な軌道として表現する。ODE-RNNでは、このNeural ODEによる連続的な変化とRNNによる観測時の更新を組み合わせ、観測間ではODEによって隠れ状態を発展させ、新しい観測が得られた時点で状態を更新する(Rubanova et al. [3], Figure 1より引用)
Latent ODE:時系列全体を連続した潜在軌道として捉える
ODE-RNNでは、観測が得られるたびに隠れ状態を更新し、その間の状態変化をODEによって表現する。一方、Latent ODE [3] では、観測された時系列全体の背後に、一つの連続的な潜在軌道が存在する と考える。
たとえば患者の血圧が数時間おきにしか測定されていなくても、患者の内部状態は観測時刻だけに存在するのではなく、その間も連続的に変化していると考える。このような観測されない内部状態を、潜在状態 z(t) として表現する。
Latent ODEでは、まず観測された時系列から初期潜在状態 z0 を推定し、その z0 を始点としてODEを解くことで、その後の潜在状態 z(t) の軌道を生成する。これにより、観測がない時間も含めた連続的な潜在軌道を求める ことができる。
つまり、観測が得られるたびに隠れ状態を更新するODE-RNNとは異なり、Latent ODEでは、初期潜在状態から時系列全体の軌道を生成する構成となっている。その構造が下の図3である。
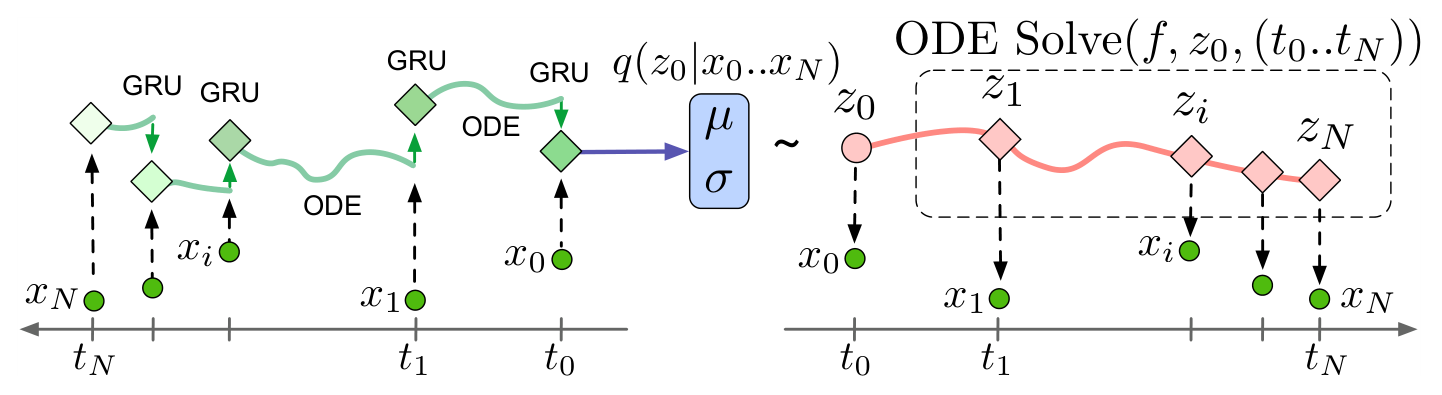
図3: ODE-RNN encoderを用いたLatent ODEの構造。左側では、観測された時系列をODE-RNNによって処理し、初期潜在状態 z0 を推定する。右側では、その z0 を出発点としてODEを解き、各時刻の潜在状態 z1, …, zN を求める。これにより、観測がない時間も含めた連続的な状態変化をモデル化する(Rubanova et al. [3], Figure 2より引用)
このように、Neural ODE系のモデルでは、不規則な時間の扱いが、経過時間に応じた減衰から、観測間の状態変化そのものを学習する方向へと広がった。
一方で、これらのモデルでは状態の時間発展を求めるためにODEを数値的に解く必要がある。そのため、連続的な状態変化を柔軟に表現できる一方で、ODE solverによる計算が必要になる。
これとは別に、観測間の状態を連続的に時間発展させるのではなく、不規則な観測時刻同士の関係をAttentionによって直接扱う という方向も提案された。その代表例の一つがmTANである。
mTAN:不規則な時刻の関係をAttentionで扱う
2021年に発表されたmTAN(Multi-Time Attention Networks)[4] は、Neural ODE系とは異なる方向から不規則時系列を扱うモデルである。
ODE系では、観測と観測の間で内部状態がどのように変化するかを連続時間でモデル化していた。一方、mTANでは、不規則な時刻に得られた観測を、Attentionを使って共通の参照時刻上の表現へ変換する。
不規則時系列では、データごとに観測された時刻や観測数が異なる。さらに多変量時系列では、変数ごとに観測時刻が異なる場合もある。そのため、観測時刻や観測数が揃っておらず、そのままでは固定長の表現として扱いにくい。
そこでmTANでは、時系列の情報を表現するための複数の参照時刻を用意し、不規則に得られた観測をそれらの時刻上の表現へ変換する。それぞれの参照時刻について、実際に得られた観測のうち「どの観測をどの程度利用するか」をAttentionによって決めることで、観測時刻や観測数が異なる時系列から固定長の表現を生成する。
では、参照時刻と観測時刻の関係をどのようにAttentionで比較するのだろうか。mTANでは、時刻 t をそのまま一つの数値として比較するのではなく、
φ(t) = [ ω(0)t + α(0), sin(ω(1)t + α(1)), sin(ω(2)t + α(2)), … ]
のように、時間の進行を表す線形成分と、周期的な変化を表す複数のsin成分からなるベクトルへ変換する。これが連続時間埋め込み(continuous-time embedding)である。ω と α は学習によって決まるパラメータであり、時刻 t をAttentionで比較するための時間的特徴を表現する。そのため、単純な時刻の差だけでは表せない、より柔軟な時間的関係をAttentionで利用できる。
そして、表現を作りたい参照時刻 r と、実際に値が得られた観測時刻 t をそれぞれ時間埋め込みへ変換し、これらをAttentionで比較する。ここで、参照時刻 r の時間埋め込みがquery、観測時刻 t の時間埋め込みがkey、その時刻に得られた観測値 xt がvalueに対応する。
たとえば参照時刻 r = 5 の表現を作るとき、観測が t = 1, 2, 8, 20 に存在していたとする。mTANは、参照時刻5に対応する表現を作るために、それぞれの観測をどの程度利用すればよいか をAttentionによって求める。イメージとしては、
(参照時刻5の表現)= 0.2x1 + 0.3x2 + 0.4x8 + 0.1x20
のように、観測値をAttentionの重みに応じて組み合わせる。ここで示した係数は説明のための例であるが、どの観測をどれだけ利用するかをモデル自身が学習する という点が重要である。この処理を複数の参照時刻について行うことで、不規則に得られた観測を、参照時刻上に並んだ表現へ変換できる。この様子を示したのが下の図4である。
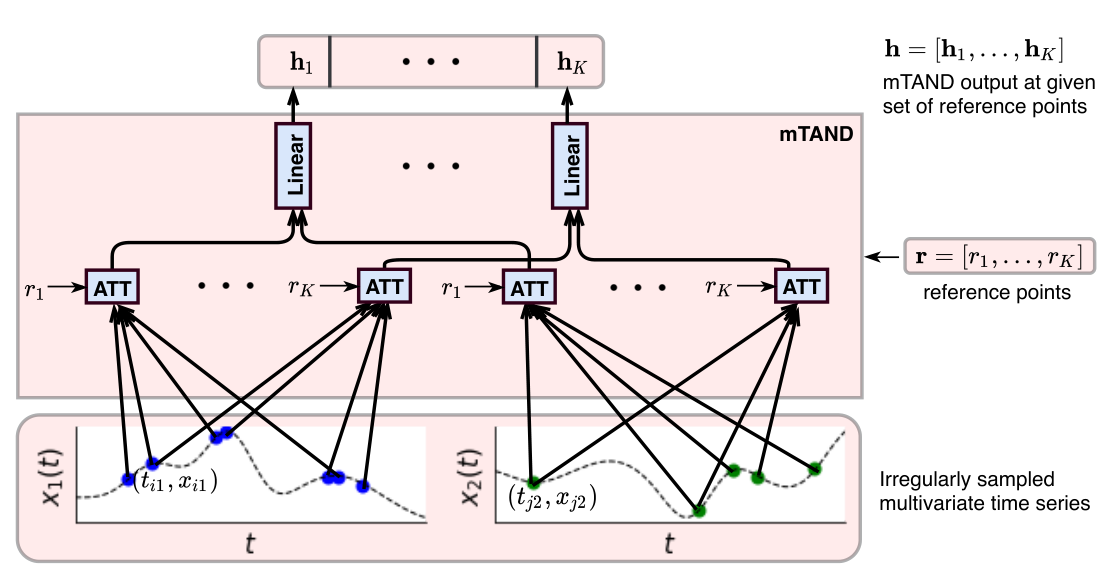
図4: mTANにおける不規則時系列の表現。下部は、異なる時刻で得られた不規則な観測を表す。mTANでは、上部に示された複数の参照時刻について、参照時刻の時間埋め込みをquery、実際の観測時刻の時間埋め込みをkey、その時刻の観測値をvalueとしてAttentionを計算する。Attentionによって観測値を重み付けしてまとめることで、それぞれの参照時刻に対応する表現を生成する。この処理により、観測時刻や観測数が異なる時系列を、共通の参照時刻上の表現へ変換できる(Shukla and Marlin [4], Figure 1より引用)
このように、mTANでは、観測間の状態変化を順に求めるのではなく、観測時刻と参照時刻の関係から直接表現を生成する。ここまでの3つを並べると、次のようになる。
- GRU-Dでは、経過時間に応じて過去の情報を減衰させる
- Neural ODE系では、観測間における状態の変化そのものを学習する
- mTANでは、参照時刻と観測時刻の時間的な関係をAttentionで学習し、不規則な観測を共通の参照時刻上へまとめる
つまり、観測されていない時間の状態を順番に進めるのではなく、「ある時刻を表現するために、どの観測をどの程度利用するか」を直接学習する という方向へ、不規則時系列の扱いが広がったのである。
ISTS-PLM:不規則時系列を事前学習済みモデルへ
GRU-D、Neural ODE系、mTANでは、不規則な観測時刻を扱うために、それぞれ専用のモデル構造や時間表現が設計されてきた。
一方、近年では、大規模なデータで事前学習された言語モデル(Pre-trained Language Model: PLM)を、時系列解析にも活用する研究が進んでいる。しかし、こうした手法の多くは、一定間隔で観測された規則時系列を対象としており、観測時刻が不規則なデータをそのまま扱うことは難しい。
不規則時系列では、観測間隔が一定でないだけでなく、多変量の場合には変数ごとに観測時刻が異なる。そのため、通常のPLMで用いられる「系列の何番目にあるか」を表す位置情報だけでは、実際にどれだけ時間が離れているのかを表現しにくい。また、各変数が異なる時刻で観測されるため、変数ごとの時間変化に加えて、変数間の関係も捉える必要がある。
そこで2025年に提案されたのがISTS-PLM [5] である。ISTS-PLMは、事前学習済みモデルが持つ系列処理能力を、不規則な観測時刻や非同期な変数を含む時系列にも利用できるようにする ことを目的としている。
まず、不規則時系列の観測値や時刻などを、PLMが扱える特徴表現へ変換する。そのうえで、通常のPLMが持つ位置埋め込みをそのまま利用するのではなく、実際の観測時刻を表す連続時間埋め込み を利用する。これにより、「系列の何番目にあるか」だけでなく、実際にいつ観測されたのか を考慮して系列内の関係を捉える。この部分がtime-aware PLM である。
さらに、多変量の不規則時系列では、それぞれの変数が異なる時刻で観測される。そこでISTS-PLMでは、各変数を個別の時系列として表現したうえで、異なる変数間の関係を捉えるvariable-aware PLM を組み合わせる。
つまり、time-aware PLMが各変数の中で「時間方向の関係」を捉える のに対し、variable-aware PLMは異なる変数同士の関係を捉える。この二つを組み合わせることで、不規則な時間変化と、非同期に観測された複数の変数の関係を同時に扱えるようにしている。
また、PLMを一から学習するのではなく、事前学習済みモデルを利用する点も特徴である。実装では、time-aware PLMにGPT-2、variable-aware PLMにBERTなどの事前学習済みモデルを利用し、これらを不規則時系列へ適応させる構成となっている。全体の構造が下の図5である。
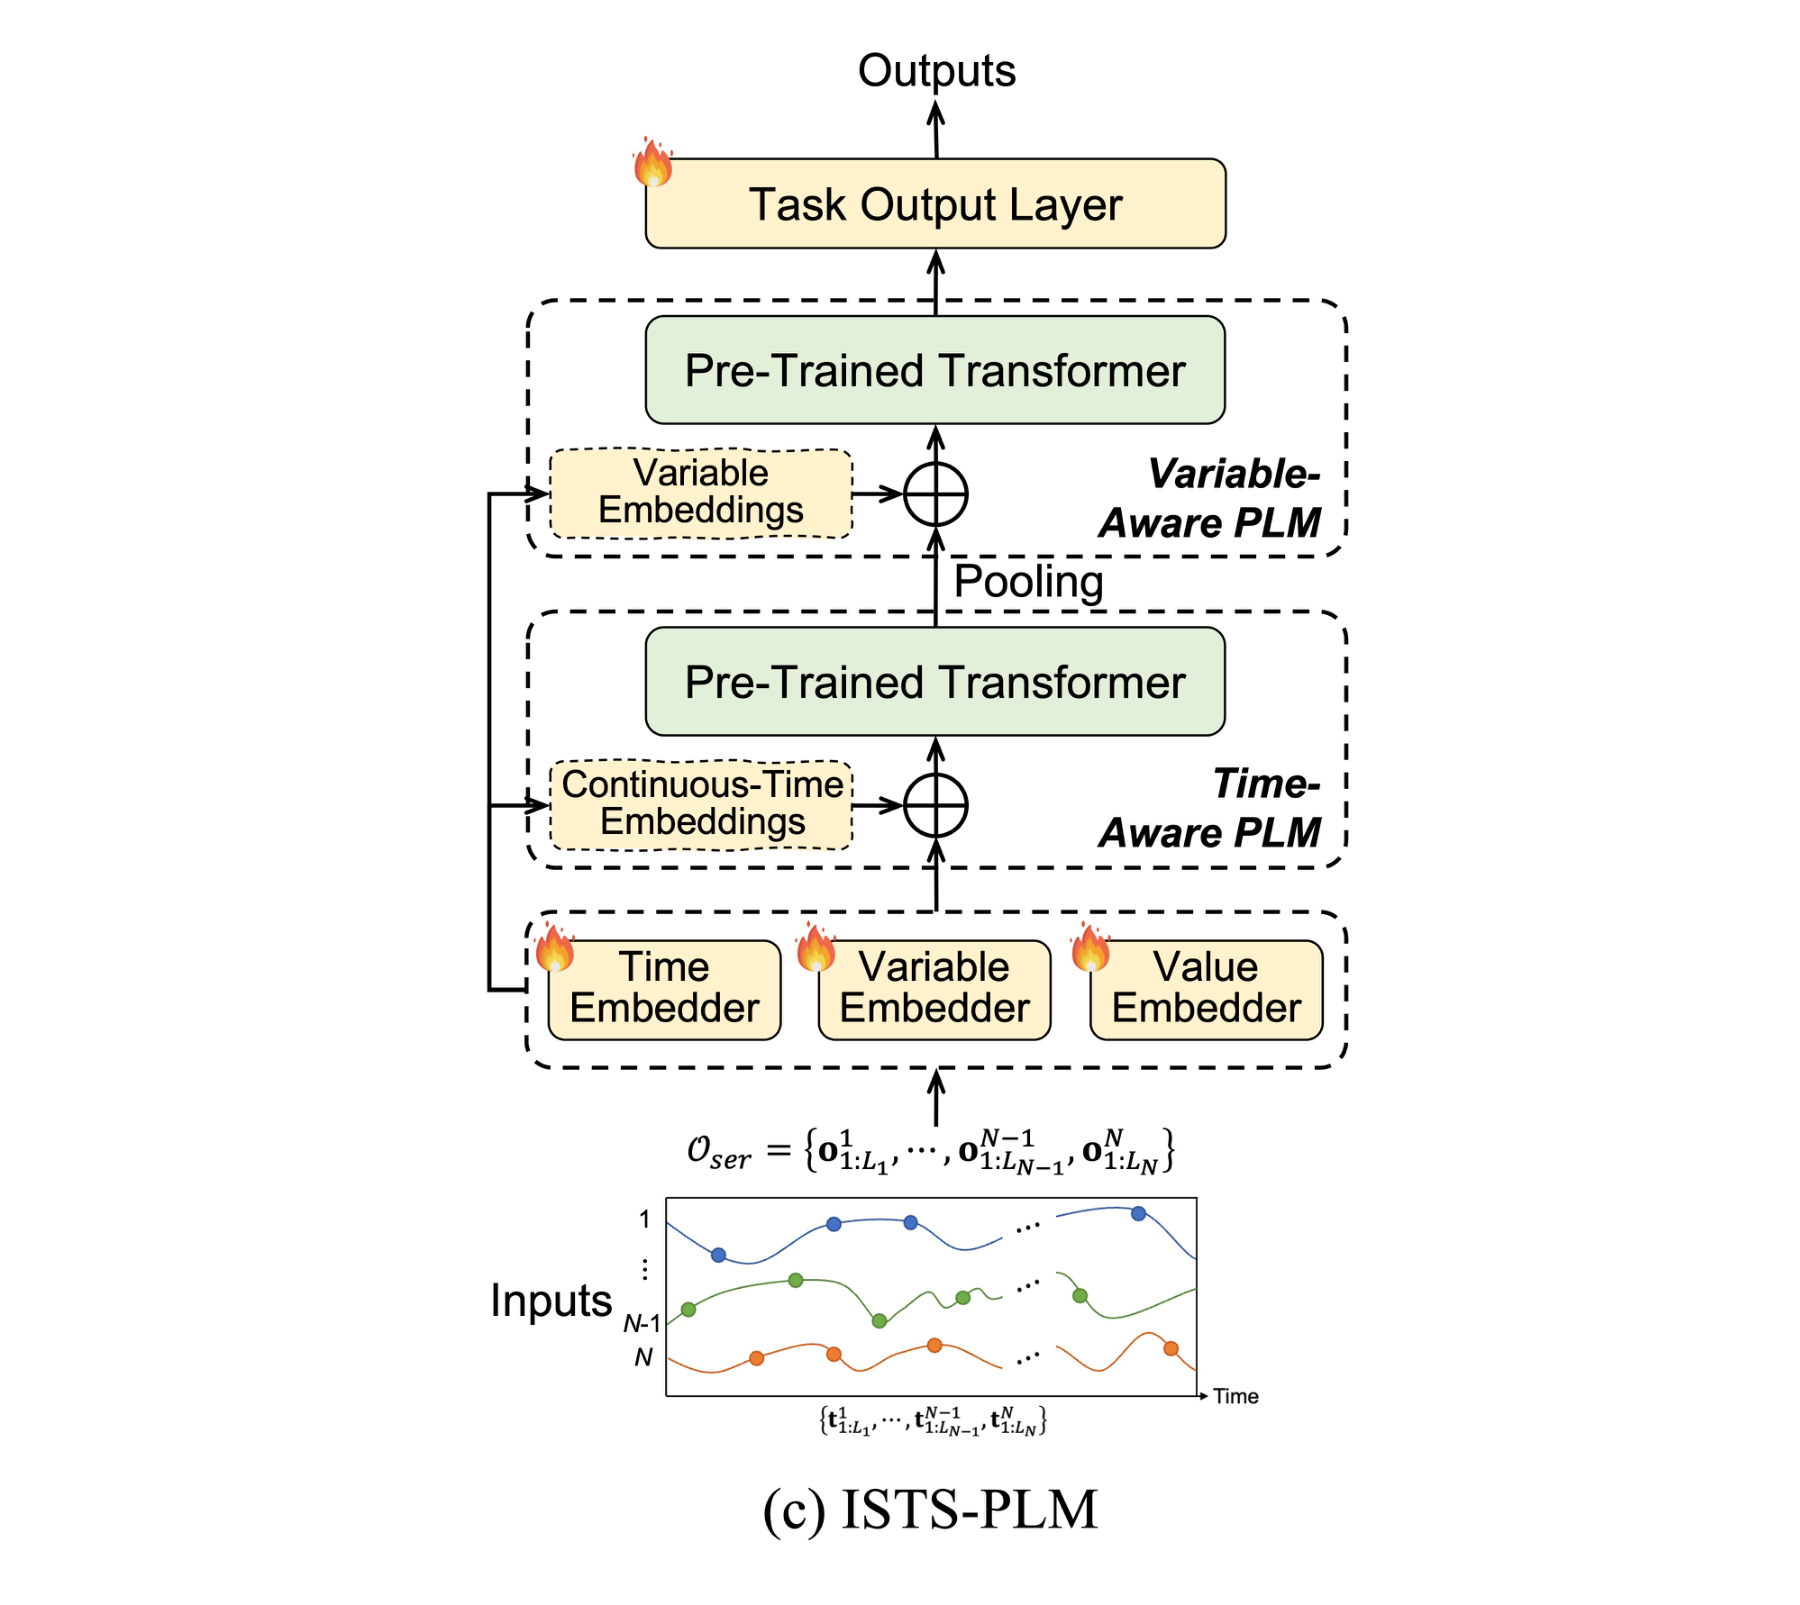
図5: ISTS-PLMの構造。各変数を個別の時系列として表現し、time-aware PLMで各変数内の時間的な関係を捉えた後、variable-aware PLMで変数間の関係をモデル化する。得られた表現は、分類・補間・外挿などの下流タスクに利用される(Zhang et al. [5], Figure 3 (c)より引用)
ISTS-PLMは、分類だけでなく、観測区間内の値を推定する補間 や、観測された区間より先の値を予測する外挿 にも利用できる。また、few-shotやzero-shotを含む設定でも評価されており、事前学習済みモデルを不規則時系列へ活用できる可能性が示されている。
このように、不規則時系列を扱う研究は、専用の時間モデルを設計するだけでなく、既存の事前学習済みモデルを不規則な時間や非同期な変数に適応させる という方向にも広がっている。
不規則時系列モデルは、時間の捉え方をどう変えてきたのか
ここまで見てきた4つのモデルを、時間の扱い方という観点から整理すると、次のようになる。
| モデル | 時間の捉え方 | 主な考え方 |
|---|---|---|
| GRU-D | 経過時間 | 古い情報を減衰させる |
| Neural ODE系 | 連続時間 | 観測間の状態変化を学習する |
| mTAN | 時刻間の関係 | Attentionによって観測を関連づける |
| ISTS-PLM | 汎用的な時間表現 | 不規則時系列に事前学習済みモデルを活用する |
こうして並べると、不規則時系列の研究は、単にニューラルネットワークの構造を複雑にしてきたのではなく、欠損値をどう埋めるか という問題から、不規則な時間をモデルの中でどのように表現するか という問題へと広がってきたと捉えることができる。
ニューロジカでは、この流れの先で、不規則時系列をネイティブに扱える時系列基盤モデルを開発している。欠損の補完や観測間隔の揃え直しを前処理として挟むのではなく、不規則な観測をそのまま入力として受け付ける設計である。本記事で追ってきた「不規則な時間をモデルの中でどう表現するか」という問いは、そのまま私たちの基盤モデルの設計の問いでもある。
参考文献
- Z. Che, S. Purushotham, K. Cho, D. Sontag, Y. Liu, "Recurrent Neural Networks for Multivariate Time Series with Missing Values," Scientific Reports, vol. 8, 6085, 2018. DOI: 10.1038/s41598-018-24271-9
- R. T. Q. Chen, Y. Rubanova, J. Bettencourt, D. K. Duvenaud, "Neural Ordinary Differential Equations," NeurIPS 2018. arXiv:1806.07366
- Y. Rubanova, R. T. Q. Chen, D. K. Duvenaud, "Latent Ordinary Differential Equations for Irregularly-Sampled Time Series," NeurIPS 2019. arXiv:1907.03907
- S. N. Shukla, B. M. Marlin, "Multi-Time Attention Networks for Irregularly Sampled Time Series," ICLR 2021. arXiv:2101.10318
- W. Zhang, C. Yin, H. Liu, H. Xiong, "Unleashing The Power of Pre-Trained Language Models for Irregularly Sampled Time Series," KDD 2025, pp. 3831-3842. arXiv:2408.08328