時系列予測の第一歩? OLTPとOLAP
はじめに
システムを作るとき、最初はたいてい、アプリサーバとRDB(PostgreSQLやMySQLなど)の2つだけというシンプルな構成から始まる。 しかし、システムがスケールすると次第に様々な要望が出てくる。 「月ごとに請求額を計算したいから、あの顧客の利用回数を集計してくれ」 「どの時期にどの商品が売れていたのか知りたいから月ごとの売れ筋を集計してくれ」
これらの要望は、そう簡単には解決できない。 スケールしたシステムは、データ量もアクセス数も多く、利用している顧客も多いからである。
そんなシステムのDBに、それらの要望を満たすクエリを投げると、どうなるか。 DBのCPUとディスクが集計に持っていかれ、通常のリクエストと取り合いになる。 最悪の場合、集計のクエリがDBのボトルネックになり、システムが機能しなくなる。
この事態を防ぐために、大規模なシステムでは通常のRDBの他に、分析用のDBを用意することが多い。 今回はその分析用DBと、分析用DBへのデータの投入方法について解説する。
OLTPとOLAP
DBは利用目的によって、大きく2つに分類される。
OLTPは、Online Transaction Processingの略で、トランザクション処理を行うためのデータベースである。 PostgreSQL・MySQL・SQLiteなどが代表的なOLTPデータベースになる。
OLAPは、Online Analytical Processingの略で、分析処理を行うためのデータベースである。 ClickHouse・BigQuery・Redshiftなどが代表的なOLAPデータベースになる。
OLTPは更新が頻繁に走るので、データの一貫性が優先される。 テーブルは正規化されていて、そのぶん結合も多くなる。
OLAPは書いたあとはほぼ読むだけなので、一貫性の要求はOLTPほど厳しくない。 結合を減らすために、非正規化しておくのが普通である。
OLTPとOLAPのデータの並べ方の違い
OLTPとOLAPの違いは、物理的なデータの並べ方にも表れる。
OLTPは通常のRDBなので、データは行指向で並ぶ。
行指向: [ID1,名前1,メール1,...][ID2,名前2,...]
特定の1ユーザーを取る処理は少ない読み込みで済む。 一方、「登録日だけ全件集計」したいときは、住所やメールまで一緒に読むことになる。
OLAPは分析用のDBなので、データは列指向で並ぶ。
列指向: [ID1,ID2,...][登録日1,登録日2,...]
分析に必要な列だけ一直線に読める。 同じ型・似たような値が並ぶので、圧縮も効きやすい。
2つを並べると図1になる。 この物理レイアウトの違いが、後で出てくる集計時間の差になる。
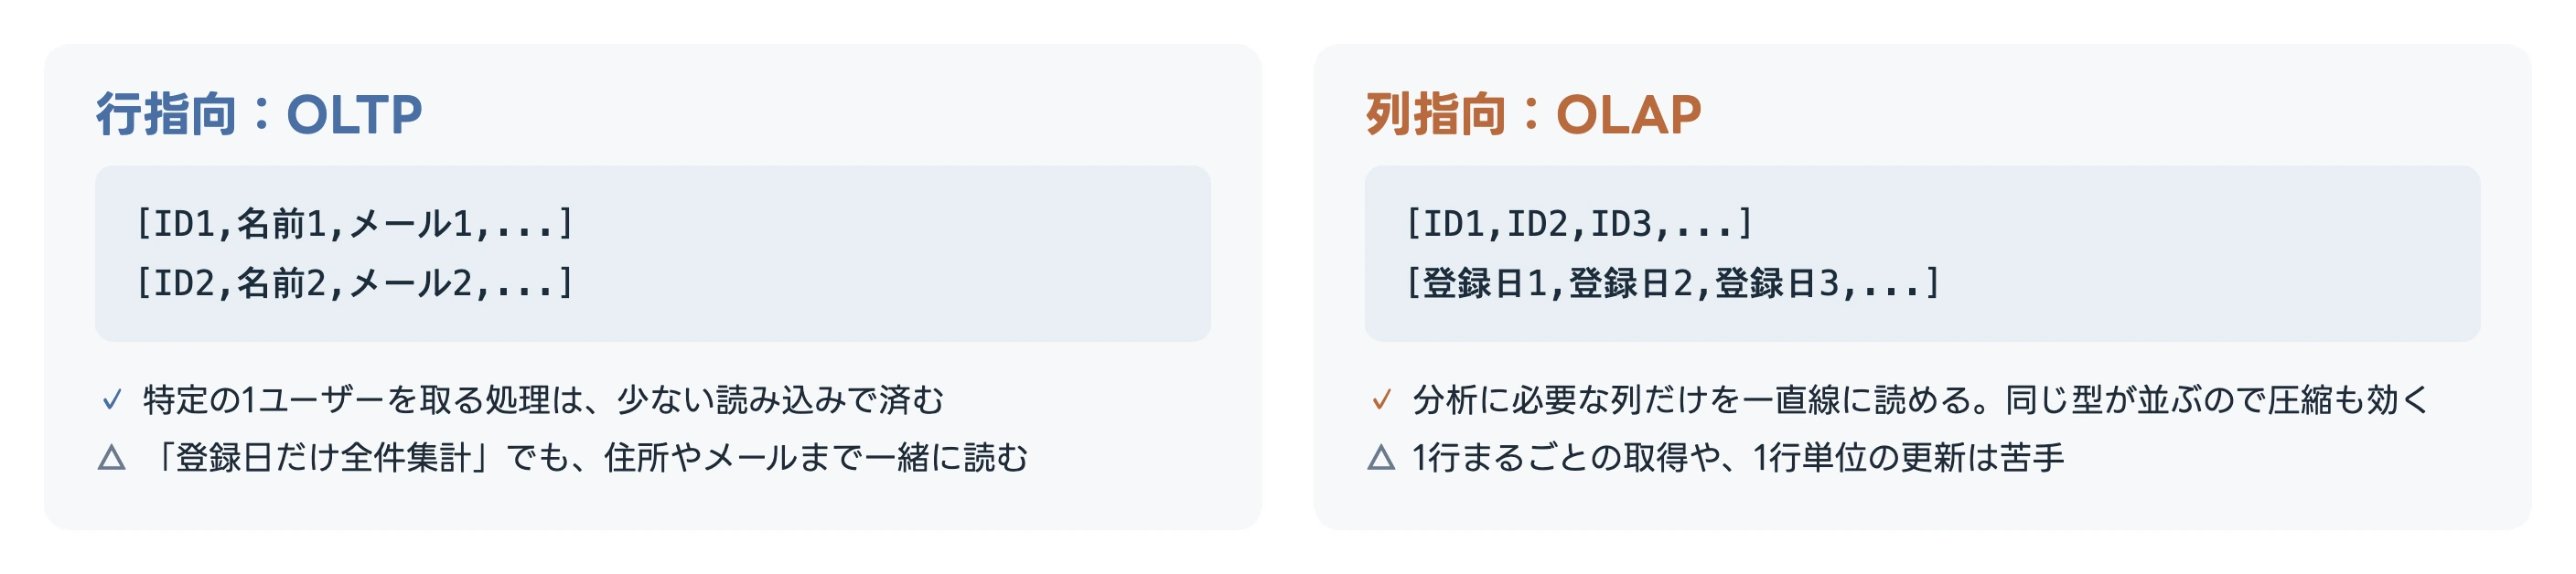
図1: 同じデータを行指向と列指向で並べたときの違い。この物理レイアウトの差が、後で見る集計時間の差になる(作図)
OLAPを始める際の要件定義
では、OLAPを始めようと思ったとき、どのような点に注意すべきか。 要件によってOLTPからOLAPへのデータの同期方法が変わってくる。
1つ目は、必要なデータの鮮度である。 月に1度でいいのか、日次か、それともリアルタイムかで、選べる同期方式が変わる。
2つ目は分析用のスキーマ設計である。 メインでしたい分析の軸によって、データの正規化はOLTPと同様でいいのか、あえて崩す必要があるのか、インデックスを別で貼る必要があるのかが決まる。
3つ目はかけられる工数である。 分析のためにどこまで工数や人員をかけられるかを決める。 バックエンドエンジニアが兼務するのか、専任のデータエンジニアが担当するのか。 OLAPへのデータ同期の方式によっては、運用コストが発生してくる。
構成は「同期方式」と「保存先」の組み合わせで決まる
OLAPの構成を選ぶことは、次の2つを選ぶことである。
- 同期方式: 本番DBからどうやってデータを運ぶか。鮮度と工数がここで決まる
- 保存先: 運んだデータをどこに置くか。分析用スキーマの自由度とクエリの速さがここで決まる
この2つは独立している。 同じClickHouseにバッチで入れてもCDCで入れても、集計の速さは変わらない。 逆に、どれだけ速く写しても、保存先が本番と同じ行指向のままなら集計は速くならない。 図2の左の矢印が同期方式、中央の箱が保存先にあたる。
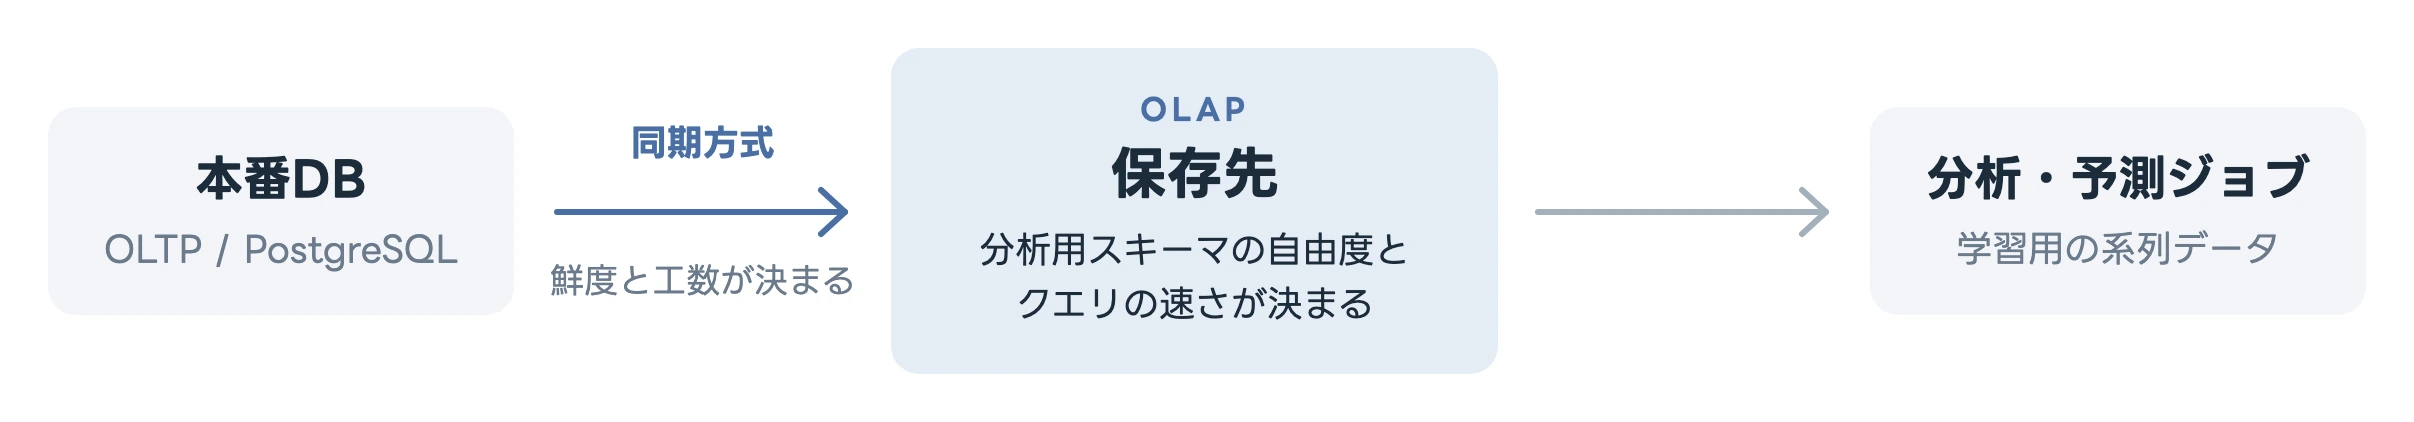
図2: 同期方式と保存先は独立して選べる。鮮度と工数は矢印の側で、集計の速さとスキーマの自由度は箱の側で決まる。同じ保存先なら同期方式を変えても集計の速さは変わらず、どれだけ速く同期しても保存先が行指向のままなら集計は速くならない(作図)
以下では、同期方式と保存先をそれぞれ4種類ずつ紹介する。 そのうえで、保存先の違う4つの組み合わせと、本番DBに直接投げる場合とで、同じクエリの実行時間を計測する。 先に結果だけ書くと、1,168万行の同じ集計に本番DBは2.29秒かかった。 TimescaleDBでは0.08秒、ClickHouseでは0.13秒、Parquetファイル + DuckDBでは0.27秒である。
本番DBはPostgreSQLを想定している。
(Spanner × BigQueryやAurora × Redshiftのようなクラウドサービス同士の組み合わせは扱わず、手元で動かして検証できるものに絞る)
同期方式 4種類
バッチ抽出
定期的にSQLでデータを抜き、保存先に投入する。
初回はフルダンプ、以降は updated_at やシーケンスIDを使って差分だけを抜くのが基本形である。
経路は図3のとおりで、本番DBと保存先のあいだに抽出・変換の一段が入る。
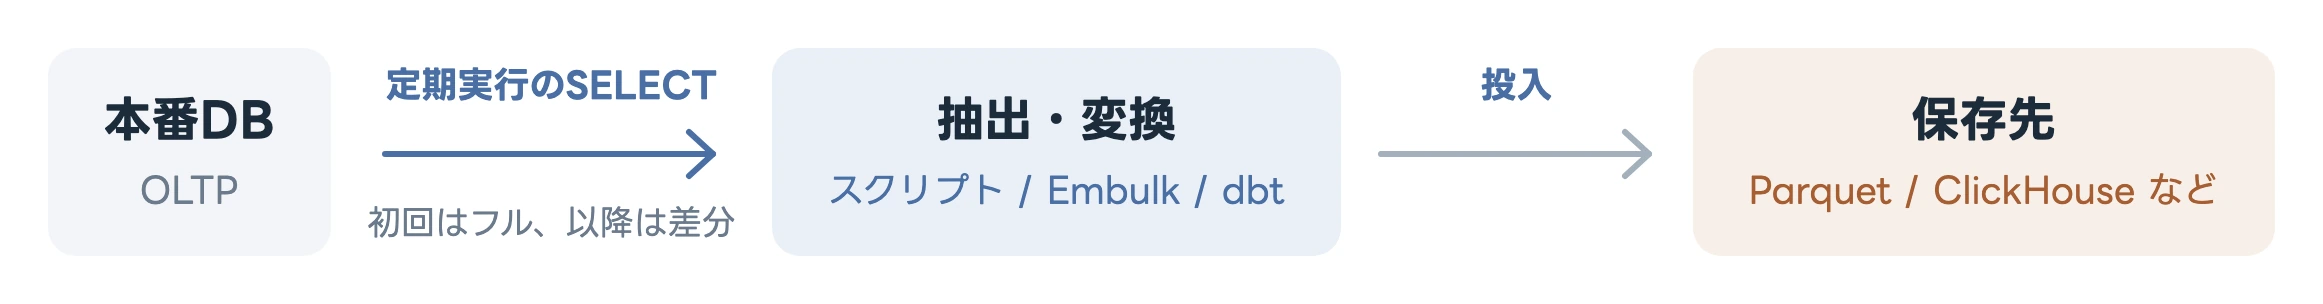
図3: バッチ抽出の経路(作図)
鮮度はバッチの間隔で決まり、数時間おきから日次が現実的なところになる。 工数は小さく、抽出と投入のスクリプト、それを定期実行する仕組みがあれば動く。 規模が大きくなったら、実行順序と失敗時のリトライをAirflowのようなツールに任せ、変換をdbtやEmbulkに寄せていく。
弱点は2つある。 1つは、抽出のたびに本番DBを読むことである(今回の計測では1,168万行・19列の全件書き出しに約31秒)。 もう1つは削除の検知で、行を物理削除すると差分抽出では追えないため、論理削除の運用が必要になる。
CDC(ログベース)
DBのトランザクションログ(PostgreSQLのWAL、MySQLのbinlog)を読み、変更をそのまま流す。 DebeziumがWALを読んでKafkaに流し、保存先の側で消費する構成が定番である [1]。 既存データは、Debeziumの初期スナップショットで入れる。 図4のように、本番DBと保存先のあいだにDebeziumとKafkaの二段が入る。
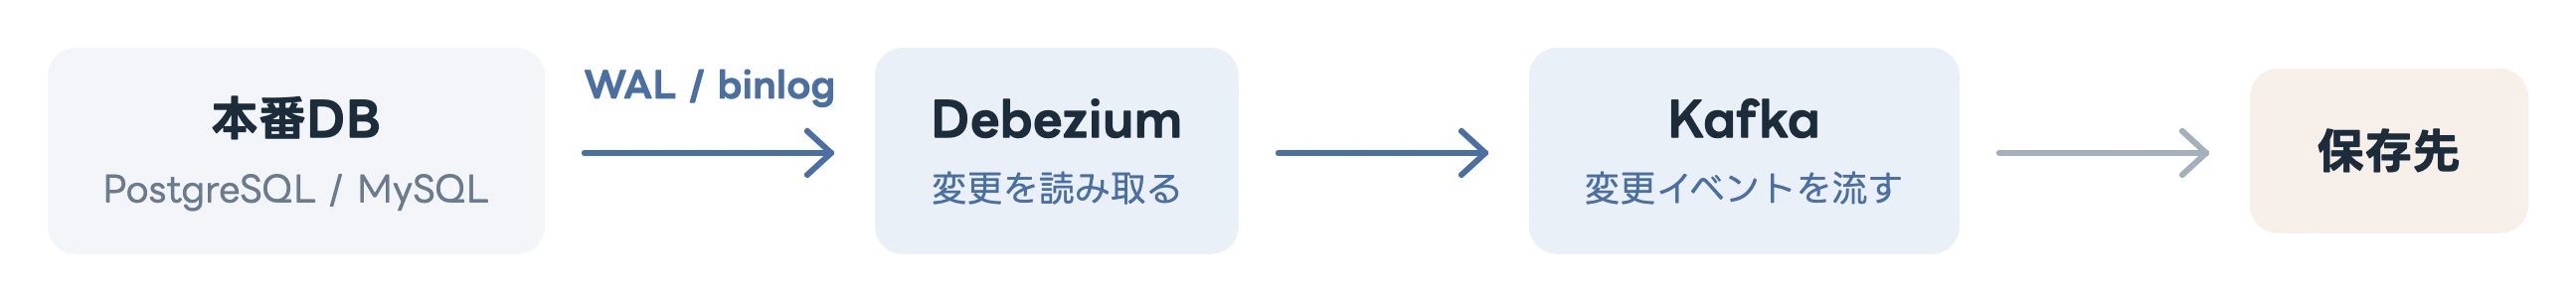
図4: CDCの経路(作図)
鮮度は秒〜分である。 本番DBにSELECTを投げないので、本番への負荷も小さく済む。
工数は4つの中で大きい。 Kafkaの運用に加えて、スキーマ変更への追従、遅延の監視、データがずれたときの再同期まで面倒を見ることになる。 専任のデータエンジニアがいる前提の構成である。
DBのレプリケーション機能
DB自身の仕組みで写す。 PostgreSQLには物理レプリケーション(ストリーミングレプリケーション)と論理レプリケーションの2つがあり、行き先が図5のように分かれる。
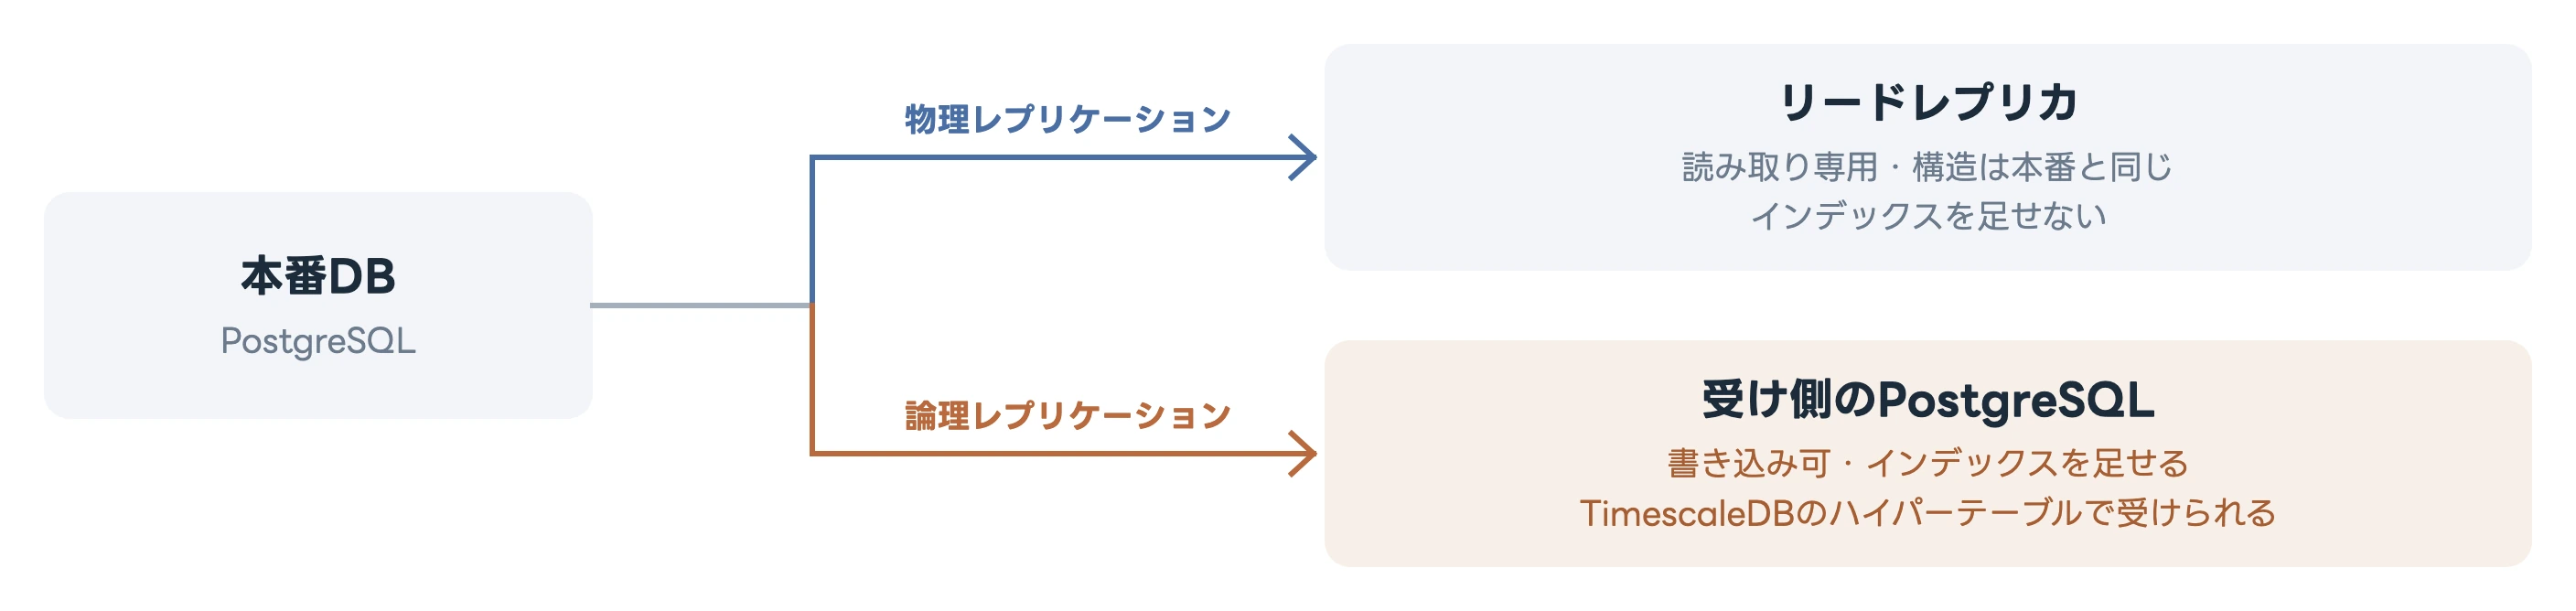
図5: 物理レプリケーションと論理レプリケーションで、受け側にできることが変わる(作図)
物理レプリケーションは、DB全体をそのままコピーする [2]。 テーブル構造も並べ方も本番と同じで、リードレプリカ側は読み取り専用になる。 分析用のインデックスをレプリカ側にだけ足す、といった調整もできない。 また、本番で更新や削除が多いと、レプリカ上の長い分析クエリがキャンセルされることがある(既定では、変更の再生を30秒以上待たせたクエリが打ち切られる)[3]。
論理レプリケーションは、テーブル単位で変更を流す [4]。 受け側は普通の書き込めるテーブルなので、分析用のインデックスを足したり、TimescaleDBのハイパーテーブルで受けたりできる。
どちらも鮮度は秒で、工数は小さい。 弱点は、保存先がPostgreSQL系に限られることである。
アウトボックスパターン
アプリは、業務テーブルへの書き込みと同じトランザクションの中で、イベントテーブル(アウトボックス)にも書き込む。 このイベントテーブルを、CDCやポーリングで外に流す。
アプリ側で流すイベントを設計でき、本番DBへの書き込みと外部への通知がずれる問題も起きない。 本番のテーブル構造をそのまま写す他の3つと違い、分析したい粒度を同期の段階で決められるので、業務の出来事そのものを残したいときに向く。 新規データ向けの仕組みなので、既存データは別途移行が必要になる。 鮮度は、イベントテーブルをCDCで流すなら秒〜分、ポーリングならその間隔で決まる。 アプリの実装が要るぶん、DB側だけで完結する他の3つより手間がかかる。
なお、アプリがOLTPとOLAPの両方に同期的に書くデュアルライトという方法もあるが、片方だけ失敗したときに整合性を保てないため、いまはあまり選ばれない。
保存先 4種類
本番DBに近いものから順に並べる。 最後のParquetファイルは、DBですらない。
本番と同じ行指向(PostgreSQLのレプリカ)
本番と同じPostgreSQLに、同じテーブル構造のまま置く。 物理レプリケーションで作るリードレプリカがこれにあたる。
スキーマは本番と完全に同じで、行指向のままである。 分析用に列を足すことも、インデックスを足すこともできない。 本番DBに分析クエリが来なくなる一方で、集計そのものは速くならない。 実際、後の計測ではレプリカの集計は3.94秒で、本番DBの2.29秒より遅いくらいだった。
TimescaleDB
TimescaleDBは、PostgreSQLに時系列データ向けの機能を足す拡張である。
別のDBサーバではなく、PostgreSQLに CREATE EXTENSION で入れて使う。
SQLもドライバも、普段のPostgreSQLのまま使える。
中心になるのは、ハイパーテーブルという仕組みである。
普通のテーブルをハイパーテーブルに変えると、時間の範囲ごと(既定では7日ごと)に内部のテーブル(チャンク)へ自動で振り分けられる [5]。
アプリからは1つのテーブルに見えたままで、WHERE sale_date >= ... のように時間で絞ると、範囲外のチャンクは読まずに済む。
もう1つが圧縮である。 チャンクの中身を、行ではなく列ごとにまとめて圧縮して持つ。 行指向のPostgreSQLの中に、チャンク単位で列指向の持ち方を持ち込むイメージになる。 ほかにも、集計結果を差分で更新し続けるマテリアライズドビュー(継続集計)や、古いチャンクを期限で消す保持ポリシーがある。
スキーマは、PostgreSQLのテーブル設計にチャンクと圧縮の設定が加わる形である。
列の定義は本番DBとまったく同じもの(後述の「計測の条件」に載せた sales_wide)を使い、そこにハイパーテーブル化と圧縮の設定を足す。
圧縮するときは「どの列でまとめるか(segmentby)」と「どの列で並べるか(orderby)」を決める。
今回は店舗IDでまとめ、日付と商品IDの順に並べた。
-- チャンクは既定の7日ごと
SELECT create_hypertable('sales_wide', 'sale_date', if_not_exists => TRUE, migrate_data => TRUE);

ALTER TABLE sales_wide SET (
  timescaledb.compress,
  timescaledb.compress_segmentby = 'store_id',
  timescaledb.compress_orderby = 'sale_date, product_id'
);
このsegmentbyとorderbyの決め方で、圧縮の効きが変わる。 TimescaleDBは同じセグメントの行を最大1,000行ずつまとめ、列ごとに配列にして圧縮するからである [6]。 segmentbyを細かく切りすぎると1バッチに入る行が減り、圧縮も列単位の読み出しも効かなくなる。 今回の設定では1バッチが平均933行になり、ハイパーテーブルはインデックス込みの2,726MBから858MBになった。
注意したいのは、使える環境が限られることである。 圧縮や継続集計は、Apache License 2.0ではなくTimescale License(TSL)の機能になる [7]。 自前で運用するぶんには無償で使えるが、これをホスティングサービスとして提供することは許されない。 クラウドのマネージドPostgreSQLでは、拡張自体を入れられないことも、入れてもこれらの機能が使えないこともある。 たとえばAWSが公開しているRDS for PostgreSQLの対応拡張一覧に、TimescaleDBは載っていない [8]。 RDSで使うことを前提にはできないので、自前で立てるか、開発元のマネージドサービスを使うことになる。
PostgreSQL互換なので、同期方式は論理レプリケーションともバッチ抽出とも組み合わせやすい保存先である。
列指向の分析DB(ClickHouse)
ClickHouseは、大量データの集計を得意とする列指向の分析DBである。 オープンソースで、開発元のClickHouse社が、マネージドサービスのClickHouse Cloudも提供している。
速い理由は、主に次の3つになる。
- 列ごとに分けて持つので、クエリに出てくる列だけを読む
- 値を1行ずつではなく、まとまった塊(ブロック)ごとに処理する
- 1つのクエリを、CPUのコアを使い切るように並列で処理する
データの持ち方の中心は、MergeTreeというテーブルエンジンである。 INSERTのたびに、ORDER BYのキー順に並べたデータの塊(パート)を書き込み、裏で少しずつ大きなパートにマージしていく [9]。 主キーのインデックスは疎で、全行ではなく、既定では8,192行に1つだけ持つ。 並び順のキーで絞り込むと、関係のない塊を丸ごと読み飛ばせる。
スキーマは、ClickHouseに合わせて設計し直す。 テーブルごとに並び順のキー(ORDER BY)を決め、よく絞り込む列を先頭に置く。 今回は店舗ID・商品ID・日付の順に並べ、月ごとにパーティションを分けた。 列は本番DBと同じ19列だが、型はClickHouseのものに置き換わる。
CREATE TABLE olap_demo.sales_wide
(
    store_id       UInt32,
    product_id     UInt32,
    sale_date      Date,
    quantity       Int32,
    amount         Decimal(12, 2),
    order_id       UInt64,
    customer_id    UInt32,
    staff_id       UInt32,
    channel        String,
    payment_method String,
    status         String,
    unit_price     Decimal(10, 2),
    discount       Decimal(10, 2),
    tax            Decimal(10, 2),
    cost           Decimal(10, 2),
    coupon_code    String,
    note           String,
    created_at     DateTime,
    updated_at     DateTime
)
ENGINE = MergeTree
PARTITION BY toYYYYMM(sale_date)
ORDER BY (store_id, product_id, sale_date);
PostgreSQL側にあった主キーとインデックスの宣言は、ここには出てこない。 ClickHouseでは、並び順のキー(ORDER BY)がそのまま主キーの役割を兼ねるためである。
一方で、OLTPと同じ感覚では使えない点もある。 1行ずつ細かくINSERTするとパートが増えすぎるため、ある程度まとめて投入するのが基本になる。 また、1行単位の更新・削除が苦手である。 CDCで流れてくる更新や削除を反映するには、ReplacingMergeTreeのように同じキーの行を後からまとめるテーブルを選ぶ必要がある。
同じ枠には、リアルタイム集計に寄せたApache DruidやApache Pinotもある。
Parquetファイル
抽出したデータを、列指向のファイル形式であるParquetに変換して置く。 保存先はファイルそのもので、DBサーバは立てない。 読むときだけDuckDBを使う。 DuckDBは、ファイルを直接読める列指向の分析DBである [10]。
スキーマは自由に決められる。 書き出すSQLでJOINしておけば、非正規化したファイルになる。 月ごと・店舗ごとにファイルを分けるのも自由である。 列指向で圧縮も効くため、今回の実験では本番PostgreSQLの2,276MBのテーブル(インデックスを除く)が469MBのファイルになった。 DBサーバが増えないので、運用するものも増えない。 経路とファイルサイズを並べると図6になる。
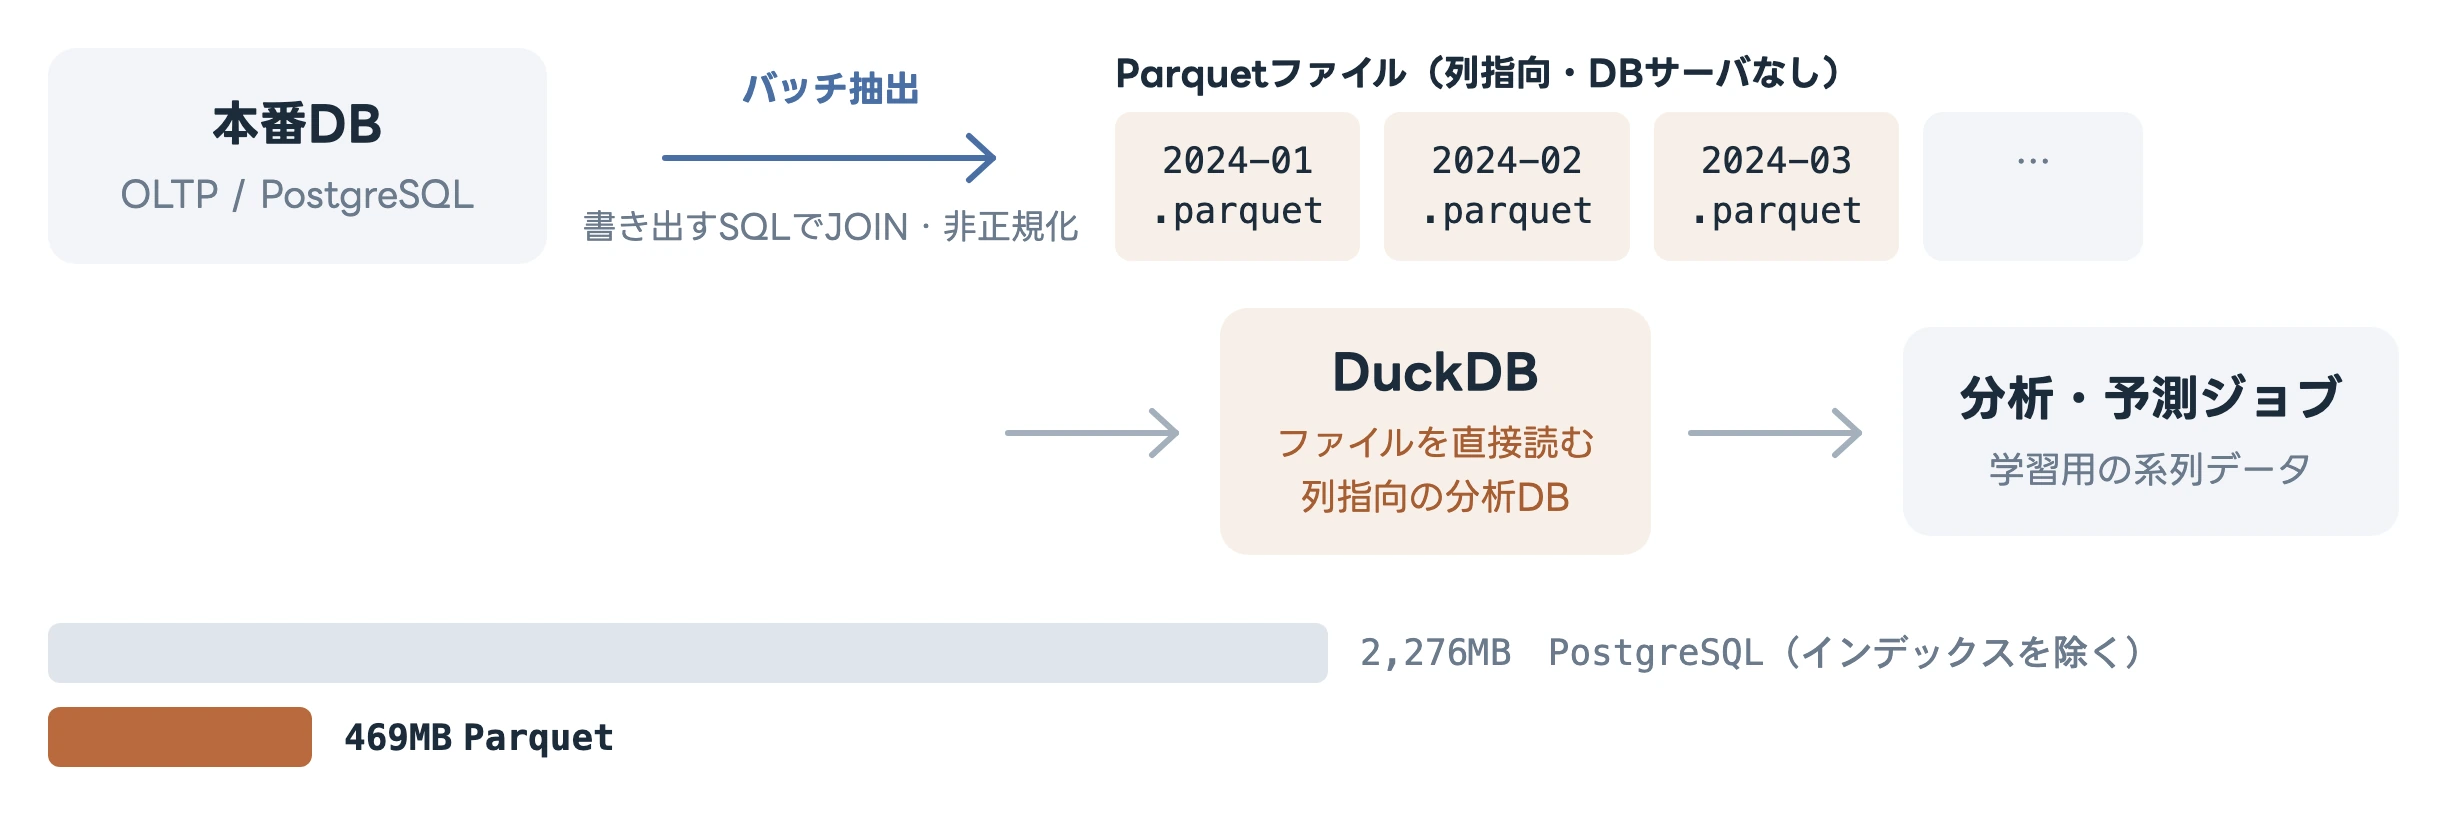
図6: Parquetに書き出してDuckDBで読む構成と、同じデータのファイルサイズ(作図)
代わりに、1行だけ書き換える、といった直し方はできない。 作り直す単位はファイルなので、修正は書き出しからやり直すことになる。 同時に読み書きする用途にも向かない。 書く人が1人、読む人が複数という前提で使うのが無難である。
データが増えてファイル数が増えてきたら、Apache IcebergやDelta Lakeでファイルをテーブルとして扱い、Trinoで読む構成に広げる道もある。
今回計測する4つの組み合わせ
同期方式と保存先を掛け合わせると組み合わせは多くなるが、クエリの速さを決めるのは保存先である。 そこで、保存先が異なる4つの組み合わせに絞り、本番DBに直接投げた場合を基準として加えた。
| 名前 | 同期方式 | 保存先 |
|---|---|---|
| 本番DBに直接 | 同期しない | PostgreSQL(行指向) |
| リードレプリカ | 物理レプリケーション | PostgreSQL(行指向) |
| TimescaleDB | 実務では論理レプリケーションかバッチ抽出 | TimescaleDB |
| CDC + ClickHouse | CDC | ClickHouse |
| バッチ抽出 + Parquet | バッチ抽出(フルダンプ) | Parquetファイル |
TimescaleDBとClickHouseは、同期方式を組まずに保存先だけを用意した。 CDCでもバッチでも、入った後の集計の速さは変わらないからである。
同じ2本のクエリを5つの構成で測る
計測の条件
MacのDocker Desktop上に次のコンテナを立てた。 すべて同じマシンで動いている。
| 役割 | 使ったもの |
|---|---|
| 本番DB | PostgreSQL 16 |
| リードレプリカ | PostgreSQL 16(ストリーミングレプリケーション) |
| TimescaleDB | timescale/timescaledb:latest-pg16 |
| ClickHouse | ClickHouse 24.8 |
| Parquetファイルの読み取り | DuckDB 1.1.3 |
データは売上テーブル1つで、80店舗 × 400商品 × 365日の1,168万行である。
テーブルは19列ある。 実務の売上テーブルに近い幅にして、予測には使わない列も一緒に置いた。 本番DB側の定義は次のとおりである。
CREATE TABLE sales_wide (
  store_id       INT NOT NULL,
  product_id     INT NOT NULL,
  sale_date      DATE NOT NULL,
  quantity       INT NOT NULL,
  amount         NUMERIC(12, 2) NOT NULL,
  order_id       BIGINT NOT NULL,
  customer_id    INT NOT NULL,
  staff_id       INT NOT NULL,
  channel        TEXT NOT NULL,
  payment_method TEXT NOT NULL,
  status         TEXT NOT NULL,
  unit_price     NUMERIC(10, 2) NOT NULL,
  discount       NUMERIC(10, 2) NOT NULL,
  tax            NUMERIC(10, 2) NOT NULL,
  cost           NUMERIC(10, 2) NOT NULL,
  coupon_code    TEXT NOT NULL,
  note           TEXT NOT NULL,
  created_at     TIMESTAMPTZ NOT NULL,
  updated_at     TIMESTAMPTZ NOT NULL,
  PRIMARY KEY (store_id, product_id, sale_date)
);

CREATE INDEX idx_sales_wide_date ON sales_wide (sale_date);
予測に使うのは先頭5列(store_id・product_id・sale_date・quantity・amount)だけである。
残り14列は、集計にも取り出しにも出てこない。
リードレプリカとTimescaleDBにも、この定義のまま同じデータを入れた。
クエリは2本に固定した。 どちらも直近1年ぶんが対象で、冒頭で挙げた「どの時期にどの商品が売れていたか」に対応する。
1本目は集計である。
19列のうち1列(quantity)を、日付ごとに合計する。
結果は365行しかないので、測れるのは「読んで集計する」コストだけになる。
SELECT sale_date, SUM(quantity) AS qty
FROM sales_wide
WHERE sale_date >= DATE '2024-01-01'
  AND sale_date <  DATE '2025-01-01'
GROUP BY sale_date
ORDER BY sale_date;
2本目は取り出しである。 19列のうち、予測に使う5列だけを取ってくる。 結果は1,168万行で、これをCSVファイルに書き出すまでを測る。
SELECT store_id, product_id, sale_date, quantity, amount
FROM sales_wide
WHERE sale_date >= DATE '2024-01-01'
  AND sale_date <  DATE '2025-01-01';
取り出しは5つの構成すべてで、CSVファイルを1本作る形に揃えた。 ClickHouseやDuckDBだけ結果を捨てる、といった差が出ないようにするためである。
計測に使ったdocker-compose.ymlとスクリプトは https://github.com/bbtit/blog-olap に置いている [11]。
結果
どの構成も同じ手順で測った。 1回捨ててから3回測った最良値である。
| 構成 | 集計 | 取り出し |
|---|---|---|
| 本番DBに直接 | 2.29秒 | 5.00秒 |
| リードレプリカ | 3.94秒 | 5.43秒 |
| TimescaleDB | 0.08秒 | 5.58秒 |
| ClickHouse | 0.13秒 | 1.49秒 |
| Parquetファイル(DuckDBで集計) | 0.27秒 | 1.09秒 |
結果から分かること
本番DBに直接投げると、集計に2.29秒、5列の取り出しに5.00秒かかった。 その間、本番DBのCPUとディスクはこの分析クエリに使われる。 1,000万行規模でも、分析を本番に同居させると無視できない時間になる。
リードレプリカに逃がしても、集計は3.94秒、取り出しは5.43秒だった。 どちらも本番DBの2.29秒・5.00秒より、むしろ遅いくらいである。 同期方式を変えても、保存先が本番と同じ行指向のままだからだ。 レプリカを別マシンに置けば本番とリソースを取り合わずに済む。 それでも、分析は速くならない。
TimescaleDBは、集計が0.08秒だった。 今回の5つの構成のどれよりも速い。 圧縮したチャンクの中身を列ごとに持っているので、集計に使う1列だけを読めるためである。 PostgreSQLのままでも、設定を合わせれば列指向の専用DBと同じ土俵に乗る。
取り出しは5.58秒で、本番DBの5.00秒とほぼ同じだった。 ClickHouseの1.49秒やParquetファイルの1.09秒には届かない。 圧縮を解いて行の形に戻し、PostgreSQLの通信で返すためだと考えている。 DB内で集計を済ませ、小さくなった結果だけを使う用途に向いている。
保存先を列指向にすると、集計の速さが大きく変わる。 同じ集計が、TimescaleDBでは0.08秒、ClickHouseでは0.13秒、Parquetファイルでは0.27秒だった。 本番DBの2.29秒に対して、順に約29倍・約18倍・約8倍である。 19列のうち必要な1列だけを読めば済むからだ。
取り出しになると差は縮む。 Parquetファイルが1.09秒、ClickHouseが1.49秒に対して、本番DBは5.00秒だった。 5列を全部持ち出すうえ、CSVを1本作る時間はどの保存先でも同じようにかかるためである。
なお、この表の数字はすべて保存先の違いによるものになる。 同じParquetをCDCで作っても、DuckDBの集計は0.27秒のままである。
どの組み合わせを選ぶか
要件定義で挙げた3つの観点(鮮度・分析用のスキーマ設計・工数)で、4つの組み合わせと本番DBに直接投げる場合を並べる。 集計の秒数は今回の計測値である。
| 組み合わせ | 鮮度 | 分析用スキーマの自由度 | 工数 | 集計 |
|---|---|---|---|---|
| 本番DBに直接 | 即時 | なし | なし | 2.29秒 |
| 物理レプリケーション + リードレプリカ | 秒 | なし(本番と同じ行指向) | 小 | 3.94秒 |
| 論理レプリケーション + TimescaleDB | 秒 | 中(PostgreSQLの設計 + チャンク・圧縮) | 中 | 0.08秒 |
| CDC + ClickHouse | 秒〜分 | 高い(ORDER BYキーから設計し直す) | 大 | 0.13秒 |
| バッチ抽出 + Parquet | バッチの間隔(日次など) | 高い(書き出すSQLで決める) | 小 | 0.27秒 |
日次や月次の分析で足りるなら、バッチ抽出 + Parquetから始めるのがよいと考えている。 工数が小さく、DuckDBで読めば集計も十分に速く出る。 失敗しても、前日のファイルを作り直せば済む。 日単位のデータで学習する時系列予測なら、多くはこの条件に当てはまるはずである。
PostgreSQLのSQLと運用のまま時系列の集計を速くしたいなら、論理レプリケーション + TimescaleDBが候補になる。 ただし取り出しは圧縮を解いて行の形に戻すぶん時間がかかるので、DB内で集計を終えて小さな結果だけを持ち出す使い方が前提になる。 圧縮がTimescale Licenseの機能である以上、使えるマネージド環境が限られる点は先に確認してほしい。
秒〜分の鮮度が必要で、運用を担える人がいるなら、CDC + ClickHouseになる。 集計0.13秒、取り出し1.49秒と両方とも速い部類である。 ただし今回の1,168万行では、集計はTimescaleDBが、取り出しはParquetファイルが上回った。 この規模で選ぶ理由は速さより、秒〜分でデータが届くことにある。 鮮度が日次で足りるのにこの構成を選ぶと、得られるものに対して運用が重すぎる。
リードレプリカは、同期方式だけを変えて保存先を変えない組み合わせなので、分析用DBの代わりにはならない。 本番を分析クエリから守るために置き、そこからParquetを書き出す元として使う、という組み合わせが現実的である。
おわりに
時系列予測のモデルを作る前に、まず学習用の系列データを取り出す必要がある。 今回の1,168万行でも、本番DBでは1列の集計に2.29秒、5列の取り出しに5.00秒かかった。 集計のクエリを本番DBから切り離し、系列データを取り出せるようにすること。 それが時系列予測の第一歩になる。
選ぶときは、同期方式と保存先を分けて考えると迷わない。 鮮度が日次で足りるなら、まずは夜間にParquetを1つ書き出し、DuckDBで読むところから始めてみてほしい。
参考文献
- Debezium, "Debezium Architecture," Debezium Documentation. debezium.io
- The PostgreSQL Global Development Group, "Chapter 27. High Availability, Load Balancing, and Replication," PostgreSQL 16 Documentation. postgresql.org
- The PostgreSQL Global Development Group, "20.6. Replication(
max_standby_streaming_delayの既定値は30秒)," PostgreSQL 16 Documentation. postgresql.org - The PostgreSQL Global Development Group, "Chapter 31. Logical Replication," PostgreSQL 16 Documentation. postgresql.org
- Timescale, "create_hypertable()(既定のチャンク間隔は7日)," Timescale Documentation. docs.timescale.com
- Timescale, "Compression(1,000行を1行の配列にまとめる。segmentby・orderbyの役割)," TimescaleDB Documentation. github.com/timescale
- Timescale, "Timescale License (TSL)," Software Licensing. tigerdata.com
- Amazon Web Services, "PostgreSQL extensions supported on Amazon RDS," Amazon RDS for PostgreSQL Release Notes. docs.aws.amazon.com
- ClickHouse, "MergeTree(主キーインデックスは既定で8,192行に1つ)," ClickHouse Documentation. clickhouse.com
- DuckDB, "Reading and Writing Parquet Files," DuckDB Documentation. duckdb.org
- 本記事の計測に使ったdocker-compose.ymlとスクリプト一式。bbtit/blog-olap