電力需要をProphetと時系列基盤モデルで予測する:効いたのはモデルではなく気温だった
「需要予測はProphetで十分では」
そう思う人もいるかもしれない。東京電力パワーグリッドが公開している日次の最大電力9年分で検証すると、Prophet(Metaが公開している時系列予測ライブラリ)は「7日前の値をそのままコピーする」だけの予測に対して、統計的に有意な差をつけられなかった(p=0.107)。
東電エリアの日最大電力9年分を対象に、14日先の予測を26回くり返して評価した。結論は次の3つである。
- 気温を共変量として与えるかどうかが、モデルの違いより効く。 共変量(予測したい値の外側から効く変数。ここでは気温)を入れると、Prophet・Chronos-2・TimesFM 2.5のいずれも誤差が41〜46%下がった。共変量ありのモデル同士の差は、最大でも19%である
- 生の気温をそのまま与えても効かない。 日平均気温をそのまま説明変数にすると、平日の需要のばらつきを2.8%しか説明できない。冷房度日・暖房度日に変換すると80.1%まで上がる
- 素のProphetは、7日前の値をコピーするだけの予測に有意な差をつけていない。 p=0.107で、26 fold(検証の区切り)のうち18勝である。モデルを置いていることと、予測できていることは別である
気温と需要はV字になる
検証の設計に入る前に、この系列の性質を押さえておく必要がある。電力需要と気温の関係は線形ではない。下の図1は、9年分の日次データを気温の順に並べたものである。
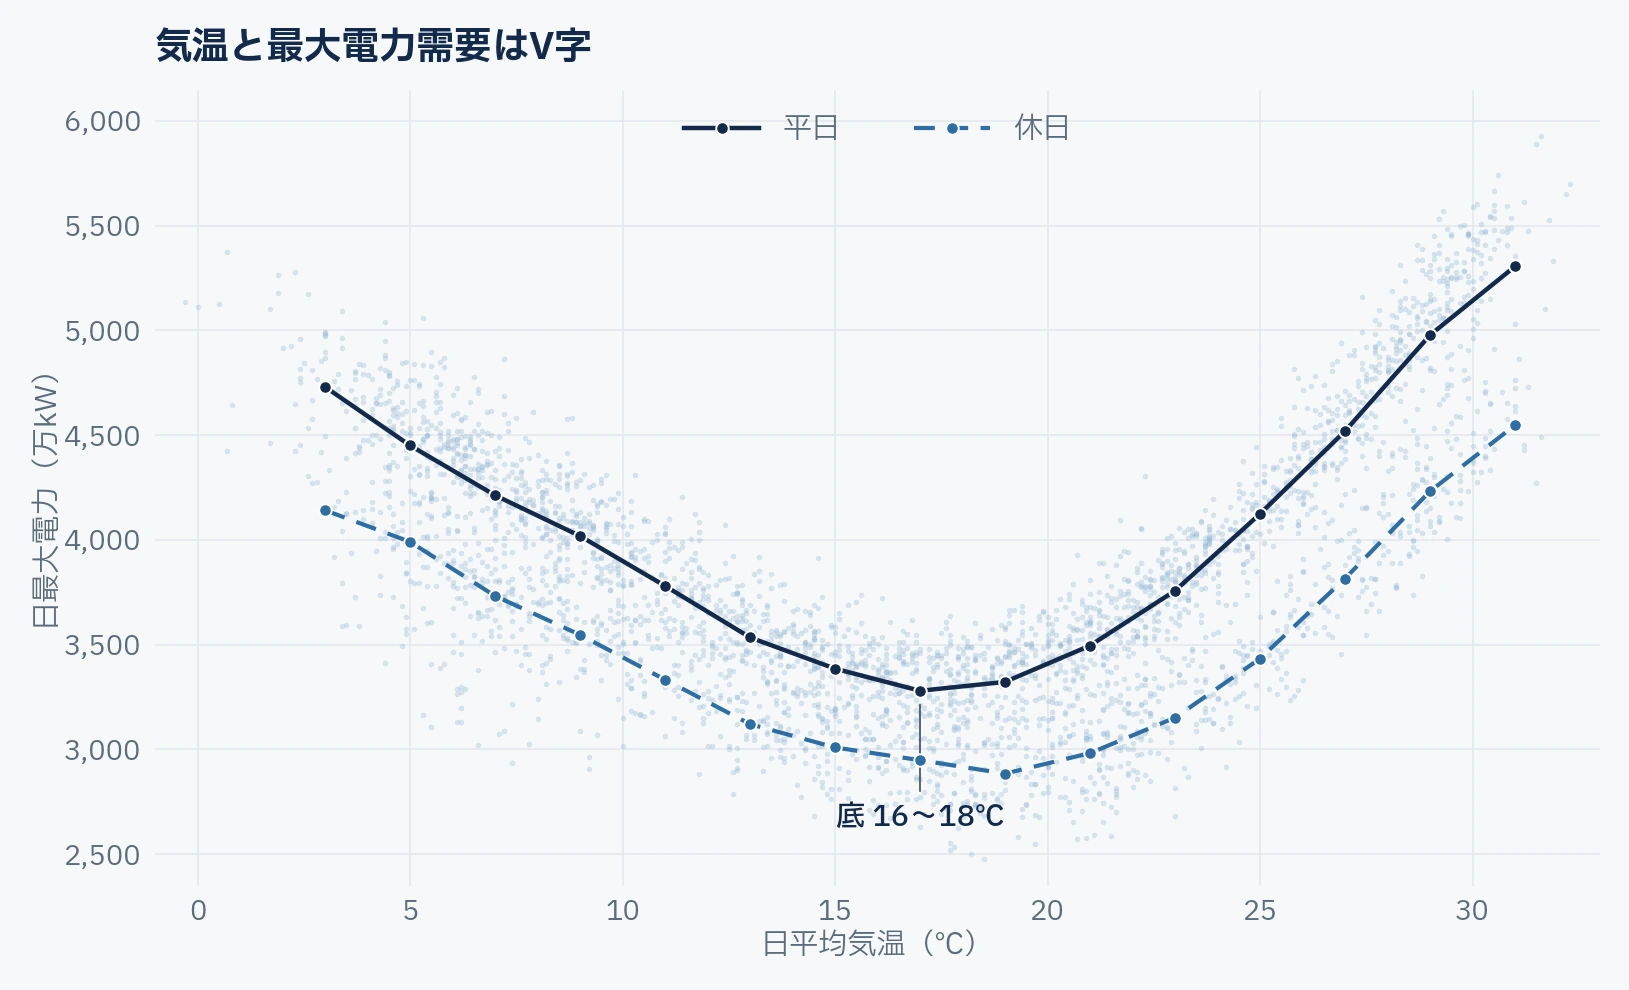
図1: 東電エリアの日最大電力(時刻別実績の日次最大値)と東京の日平均気温。2016年4月から2025年7月までの3,399日。線は気温2℃刻みのビン平均で、各ビン20日以上のものだけを表示している。平日の需要は16〜18℃で底を打ち、そこから30〜32℃では61.8%、2〜4℃では44.2%高くなる(作図)
底を挟んで両側に立ち上がるため、気温をそのまま説明変数として与えても直線では追えない。実際に平日だけで単回帰をかけると、次のようになる。以降の表では、列名の↑が値の高いほうが良い指標、↓が低いほうが良い指標であることを示す。
| 説明変数 | 相関係数 r ↑ | 決定係数 R² ↑ |
|---|---|---|
| 日平均気温(そのまま)、1本 | +0.169 | 0.028 |
| 冷房度日と暖房度日を足して1本 | +0.895 | 0.801 |
冷房度日・暖房度日は、しきい値からのずれを片側だけ取る変換である。冷房度日は20℃を超えた分だけを数えるので、25℃の日は5、18℃の日は0になる。暖房度日は12℃を下回った分だけを数えるので、8℃の日は4、18℃の日は0になる。V字の両腕を折り返す処理で、説明力が2.8%から80.1%に変わる。しきい値は冷房側16〜27℃、暖房側6〜19℃を1℃刻みで総当たりして選んだ。
上の表はどちらも説明変数1本の単回帰なので、rは単純な相関係数である。冷房度日と暖房度日は足して1本にまとめている。いっぽう以降の検証では、この2つを別々の説明変数としてモデルに渡している。2本に分けて重回帰をかけると決定係数は0.802で、足して1本にした0.801とほとんど変わらない。重回帰の相関は重相関係数になるため、rは併記していない。
データ
使用したのはすべて公開データである。出典と期間を次に示す。
| 項目 | 内容 |
|---|---|
| 目的変数 | 東電エリアの日最大電力(万kW) |
| 出典 | 東京電力パワーグリッド「でんき予報」の時刻別実績 |
| 共変量 | 東京の日平均気温から作った冷房度日・暖房度日、曜日、休日フラグ |
| 出典 | 気象庁「過去の気象データ検索」(東京、観測所番号47662)を加工して作成 |
| 期間 | 2016年4月1日から2025年7月21日までの3,399日 |
| 気温の範囲 | −0.3〜32.3℃(平均16.9) |
平日の平均は休日の平均を15.2%上回る。図1で濃紺と青の線が上下に離れているのがこの差である。
検証は2026年8月に実施した。需要側は24時間そろっている日だけを採用した。期間が2025年7月21日で切れているのは、検証に用意した時刻別実績のファイルがここまでだったためである。したがって評価期間は、この記事の公開時点から1年ほど前までを対象にしている。
検証のやり方
| 項目 | 設定 |
|---|---|
| 予測ホライズン(一度に何日先まで予測するか) | 14日先 |
| 検証方法 | rolling-origin backtest(学習期間を14日ずつ前に進めながら繰り返す)、26 fold |
| 評価期間 | 2024年7月23日から2025年7月21日までの364日 |
| 学習データ | 各foldの直前まで全期間(最短でも約8年) |
| 入力履歴 | 各foldの全期間を渡した(最長3,385日。両モデルのコンテキスト長(一度に読み込める過去の点数)の上限内) |
| 主な指標 | MASE |
MASEは、予測の平均絶対誤差を「学習期間内で7日前の値をコピーしたときの平均絶対誤差」で割った値である。Hyndmanら [1] が提案した指標で、単位に依存せず、1.0が「学習期間の週次ナイーブと同水準」を意味する。この分母はfoldごとに学習期間から計算しており、今回は26 foldの平均で342.7万kW(範囲339.8〜345.1)だった。指標そのものの選び方が結論を左右する問題については、当ブログに誤差指標と意思決定を扱った記事がある。
比較したのは次の7構成である。
SeasonalNaive(7):7日前の値をそのままコピーする。下限のベースライン。本文では以降「週次ナイーブ」と呼び、表とグラフではSeasonalNaive(7)と表記するProphetとProphet +XReg:年周期・週周期・日本の祝日、乗法季節性(季節変動を水準に足すのではなく掛ける形で入れる設定)。XRegは外生説明変数(予測したい値の外側から効く変数)の略である。XRegありの構成では、冷房度日・暖房度日をadd_regressorで追加したChronos-2とChronos-2 +Cov:amazon/chronos-2(約1.2億パラメータ)。共変量をモデル内部で扱う設計なので、接尾辞もAPIの語に合わせて+CovとしたTimesFM-2.5とTimesFM-2.5 +XReg:google/timesfm-2.5-200m-pytorch(約2.3億パラメータ)
共変量の入れ方は2つのモデルで違う。Chronos-2はモデル内部の入力として受け取り、TimesFM 2.5のXRegは共変量に対するリッジ回帰(係数が大きくなりすぎないように抑えた線形回帰)を外付けして、その残差を本体が予測する。
結果
図2に平均MASEを示す。濃紺が気温を与えた構成、淡青が与えていない構成である。
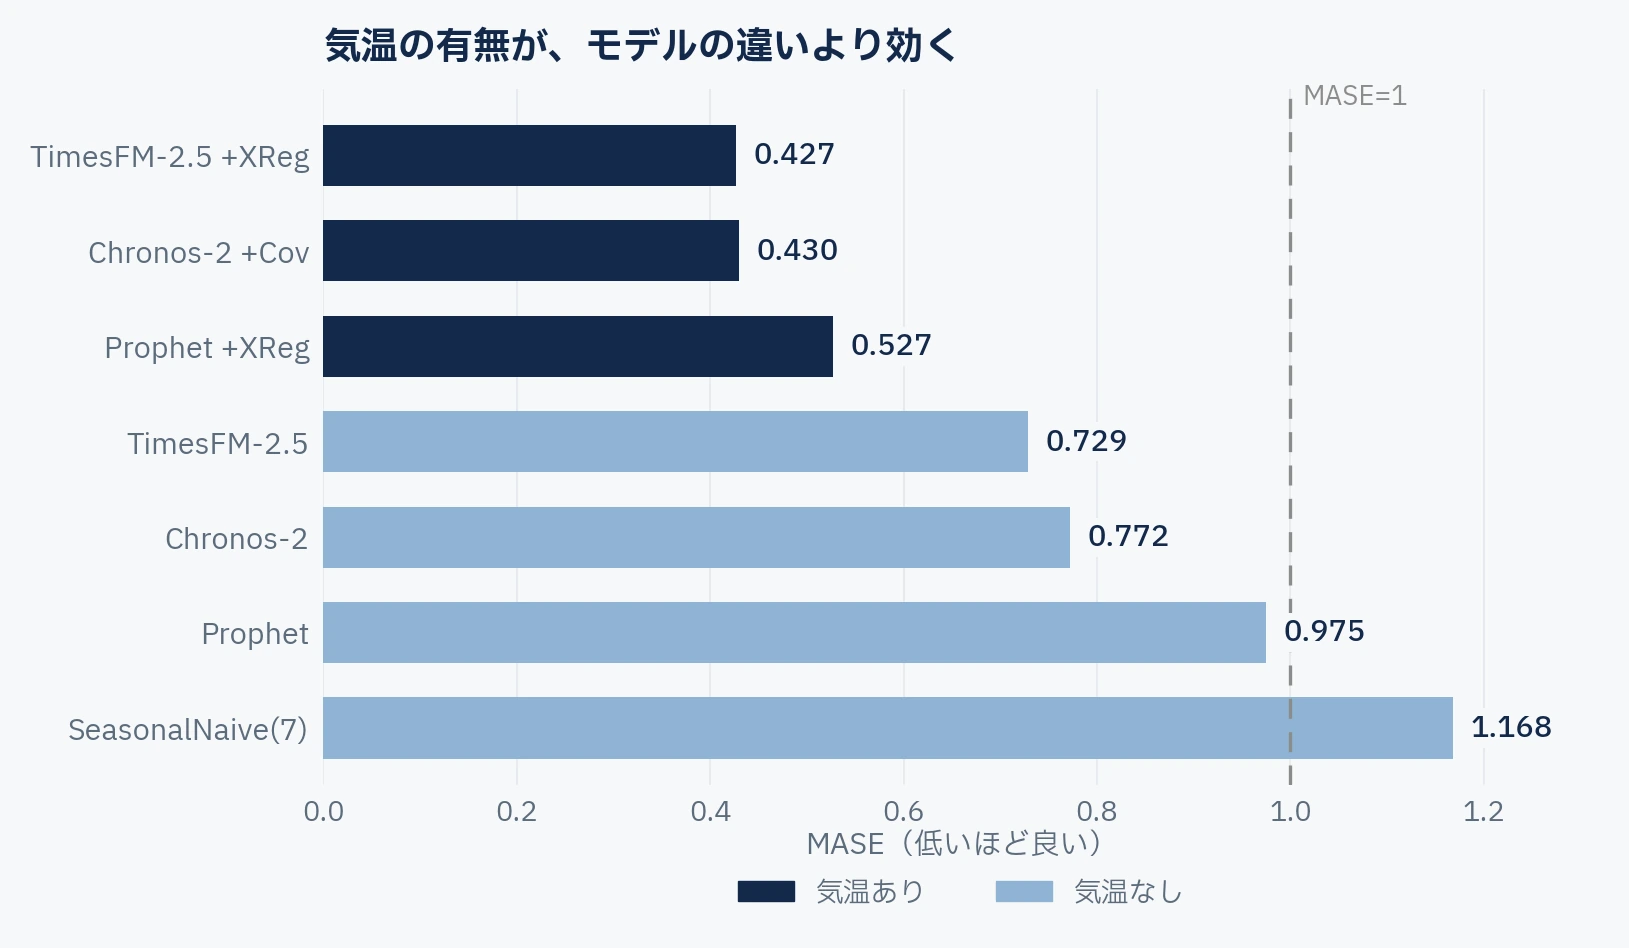
図2: 26 foldの平均MASE。低いほど良い。破線のMASE=1は学習期間の週次ナイーブと同水準の位置を示す。気温を与えた3構成(濃紺)が0.427〜0.527に収まり、与えていない4構成(淡青)の0.729〜1.168と分かれている(作図)
数値で並べると次のようになる。各列の最良値を太字にし、MASEの良い順に下から並べた。
| モデル | MASE ↓ | sMAPE ↓ | MAE(万kW)↓ | RMSE ↓ | WQL ↓ |
|---|---|---|---|---|---|
| SeasonalNaive(7) | 1.168 | 10.34% | 399.8 | 493.5 | 該当なし |
| Prophet | 0.975 | 8.57% | 333.7 | 386.5 | 0.0669 |
| Chronos-2 | 0.772 | 6.76% | 264.4 | 324.3 | 0.0522 |
| TimesFM-2.5 | 0.729 | 6.50% | 249.7 | 304.3 | 0.0506 |
| Prophet +XReg | 0.527 | 4.69% | 180.6 | 215.7 | 0.0371 |
| Chronos-2 +Cov | 0.430 | 3.79% | 147.2 | 187.0 | 0.0304 |
| TimesFM-2.5 +XReg | 0.427 | 3.79% | 146.2 | 177.6 | 該当なし |
MAE(平均絶対誤差)146.2万kWは、評価期間の平均需要に対して3.83%にあたる。参考として併記したsMAPEは誤差を実測値との比で見た指標、RMSEは大きな外れを重く数える指標、WQLは予測区間の当たり具合を測る指標で、いずれも低いほど良い。順位はMASEと変わらない。
26 foldの予測にかかった時間(CPUのみ、重みの読み込みは除く)は、Prophetが6.6秒、Prophet +XRegが10.0秒、基盤モデルは4.2〜8.8秒だった。基盤モデルに替えても遅くはならない。
差が偶然でないかを確かめる
平均値の差だけでは、たまたま良かった年の影響を否定できない。そこで26 foldの誤差を対にして、並べ替え検定(分布の形を仮定せずに「差が偶然この大きさになる確率」を数える方法)にかけた。
Prophetに気温を与えると、MASEは0.975から0.527に下がり、26 foldのうち24勝、p値は0.0001未満だった。偶然とは考えにくい。Chronos-2とTimesFM 2.5でも同じで、いずれも23勝、p値は0.0001未満である。改善率は41〜46%で、これに対して共変量あり同士の差は19%にとどまる。
これに対して素のProphetと週次ナイーブの差は、平均では0.975と1.168だが、18勝でp=0.107にとどまる。foldごとのばらつきを考えると、差があるとは言えない。
夏はどのモデルも誤差が開く
図3は、26 foldのMASEを時間の順に並べたものである。網掛けは夏の期間を示す。
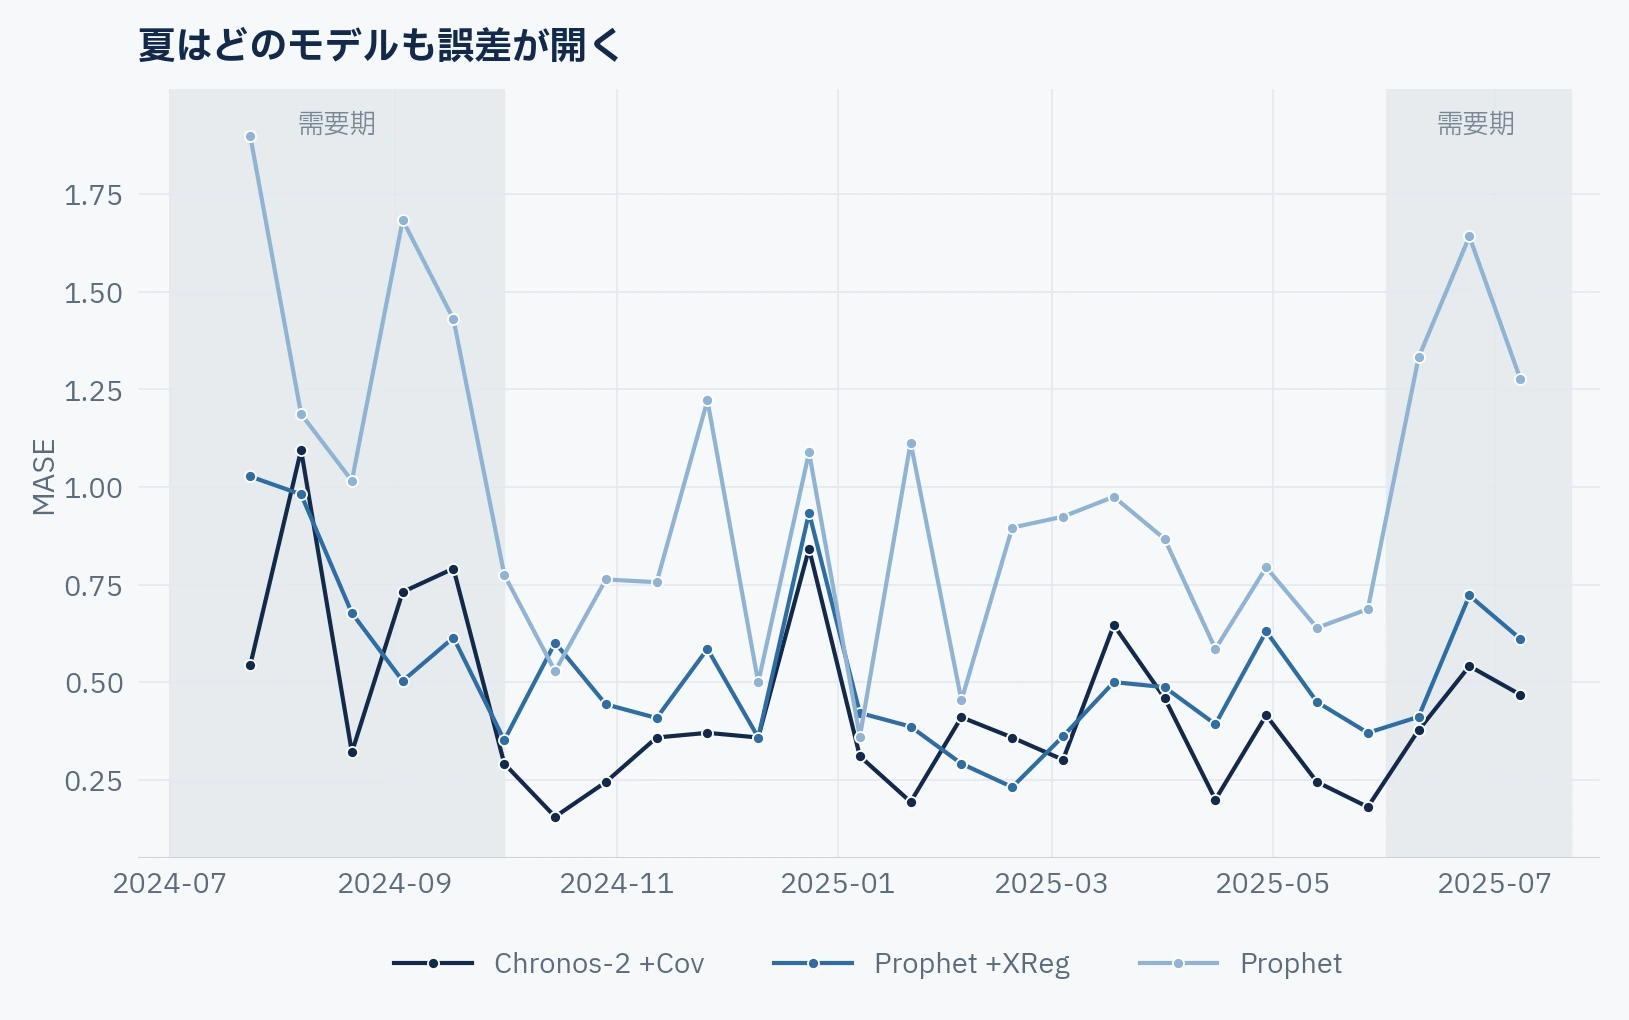
図3: 各foldの開始日を横軸に取ったMASEの推移。「需要期」と網掛けしたのは2024年7月から9月、および2025年6月から7月21日である。この区間で3構成すべてが上振れし、共変量なしのProphet(淡青)の振れ幅が大きい。見やすさのため7構成のうち3つを表示している(作図)
fold開始月が6〜8月のものを夏として、4つの季節に割り当てると、季節ごとの平均MASEは次のようになる。行の順は結果の表と同じ全体MASEの良い順で、季節ごとに見ると順位は入れ替わる。図3の網掛けは需要が上がる時期に取っているため、この表の季節区分とは範囲が一致しない。
| モデル | 春(3〜5月開始)↓ | 夏(6〜8月開始)↓ | 秋(9〜11月開始)↓ | 冬(12〜2月開始)↓ |
|---|---|---|---|---|
| SeasonalNaive(7) | 0.956 | 1.399 | 1.078 | 1.287 |
| Prophet | 0.778 | 1.385 | 1.031 | 0.728 |
| Chronos-2 | 0.567 | 1.086 | 0.818 | 0.643 |
| TimesFM-2.5 | 0.611 | 0.988 | 0.685 | 0.659 |
| Prophet +XReg | 0.457 | 0.739 | 0.503 | 0.427 |
| Chronos-2 +Cov | 0.351 | 0.544 | 0.427 | 0.412 |
| TimesFM-2.5 +XReg | 0.383 | 0.532 | 0.392 | 0.412 |
夏が弱点になる点は7構成すべてに共通している。共変量なしのProphetは夏にMASE 1.385まで悪化し、週次ナイーブの1.399に並ぶ。猛暑日の需要の跳ね上がりは、週周期と年周期の分解では表現できていない。
共変量は最悪ケースにも効いている。共変量なしの3構成は最悪foldでMASE 1.42〜1.90まで落ちたが、共変量ありでは0.78〜1.10に収まった。運用で誤差の上限を約束する場面では、平均よりこちらが重要になると考える。
区間が出るかどうかで分かれる
共変量の入れ方は、精度だけでなく出力の形も変える。TimesFM 2.5のXRegは共変量への回帰を本体の外に付ける構成なので、共変量を使うと分位点(分布の中で「下から何%」にあたる値)が出なくなり、点予測しか返らない。Chronos-2は共変量をモデル内部で扱うため、共変量ありでも予測区間が残る。
点予測の精度は2つでほぼ並んだ(MASE 0.427と0.430)。しかし需給計画のように「上振れが何%の確率で起きるか」を使う場面では、区間が出るかどうかが意思決定を分ける。区間まで必要なら、今回の構成で選ぶのはChronos-2になる。
この検証の限界
- 気温は実績値を与えている。 実運用では気象予報を使うので、予報誤差の分だけ悪化する。MASE 0.43は実運用の期待値ではない
- しきい値(20℃・12℃)は全期間から選んだ。 ただし各foldの学習期間だけで選び直しても同じ値になったので、結論は動かない
- Prophetは既定値のまま。
changepoint_prior_scaleなどを詰めればProphet +XRegは伸びる余地がある。日次・単一系列の結果なので、時間値のように日内周期が入る系列では変わりうる - 基盤モデルはゼロショットで使った。 事前学習データに評価期間と重なる公開データが含まれる可能性は排除できない
まとめ
- 対象の系列が気温のような外生要因で動いているなら、モデルを乗り換える前に共変量を設計する。今回は共変量の有無で41〜46%、モデルの違いで19%だった
- ただし生の変数をそのまま与えても効かないことがある。V字なら冷房度日・暖房度日のように折り返す。決定係数0.028と0.801の差はここで生まれた
- 共変量の入れ方は出力の形も変える。外付けの回帰で入れると、予測区間が出なくなることがある
素のProphetが週次ナイーブに有意な差をつけていなかった点は、この検証で予想外だった。モデルを置いていることと、予測できていることは別である。単純なベースラインが凝った手法に並んでしまう構図は、時系列予測では繰り返し報告されている。当ブログのLLMによる時系列予測を扱った記事にも、LLM部分を取り除いても精度が落ちなかった検証や、線形1層のモデルがTransformer系を上回った報告がまとめられている。手元のモデルを週次ナイーブのような素朴なベースラインと並べてbacktestしていないなら、そこから始める価値があると考える。
手順にすると、次のようになる。
- 手元のモデルと週次ナイーブをbacktestで並べ、差が偶然の範囲かを確かめる
- 目的変数を動かしている外生変数を洗い出す
- その変数と目的変数の関係を散布図で見て、非線形なら折り返してから共変量に入れる
参考文献
[1] Rob J. Hyndman, Anne B. Koehler. "Another look at measures of forecast accuracy." International Journal of Forecasting(予測研究の国際学術誌), 22(4), 679-688, 2006. DOI: 10.1016/j.ijforecast.2006.03.001