等間隔でないデータはなぜ普通のモデルで予測できないのか
当ブログの不規則時系列モデルの系譜:GRU-D・Neural ODE・mTANから最新まででは、不規則な観測をモデルの側で受け止める設計を、GRU-D から最新の研究まで追った。本記事はその前提にあたる。不規則時系列とは何か、なぜ普通のモデルはそれを扱えないのか、等間隔にそろえる前処理で何が落ちるのかを、合成データと PhysioNet の集計で確かめる。
「間隔がバラバラなデータなら、resample で等間隔にしてからモデルに入れればいい」
この考えは半分正しい。医療の検査値、設備のイベントログ、雲を除いた衛星観測。こうした記録の間隔がバラバラなデータを不規則時系列(irregularly sampled time series)という。渡されたときにまずやることは決まっていることが多く、df.resample('1h').interpolate() と書いて等間隔の配列にし、いつものモデルに流し込む。あとで実測を出すが、不規則なまま渡すより精度の数字ははっきり良くなる。この resample の一行が疑われないのは、実際に効くからである。 だが、そのとき普通のモデルが予測しているのは元のデータではない。言いたいことは3つある。
- 普通のモデルは不規則時系列を扱えない:等間隔に並んだ配列を要求する設計で、1ステップを一定の時間幅とみなしている。そのまま渡すと実際に精度が出ない
- 等間隔化は「いつ測ったか」を捨てる:精度の数字は出る。だが落ちた情報による歪みは精度の数字に出ないので、気づきにくい
- 前処理は応急処置:普通のモデルに渡すために捨てた情報は戻らない。それで足りる条件もあるので、その条件も挙げる
ただ、この前処理を通したあと、12回測った1時間と、1回も測らなかった1時間は、同じ1つの数値になっている。後者は補間で埋めた値だが、列に並んでしまえば区別はつかない。そして現場によっては、測った回数のほうにこそ意味がある。悪化したから頻繁に測り、落ち着いていたから翌朝まで測らなかった、というように。同じ前処理は、現場だけの話ではない。あとで見るが、時系列基盤モデルの推奨手順にも出てくる。
不規則時系列とは何か
数時間おきにしか測らない検査値を1時間格子(1時間おきの時刻の並び)に載せれば、ほとんどのセルが「欠損」に見える。だが現場で起きていることは、値が抜けたことではない。測る間隔が、変数ごとに違うことである。
欠損と不規則時系列は、現場ではほぼ同じ言葉で呼ばれる。しかし定義は違う。
- 欠損: 想定された格子点に値がない。だから「本来あるはずの値が抜けている」と言える
- 不規則: そもそも共通の格子が存在しない。観測時刻が事例ごと、変数ごとに違う。これが不規則時系列である
欠損という概念は、固定間隔の格子があって初めて定義できる。格子を後から置くと、不規則な観測は欠損に「化ける」。 Shukla と Marlin のサーベイが、この変換を図にしている。
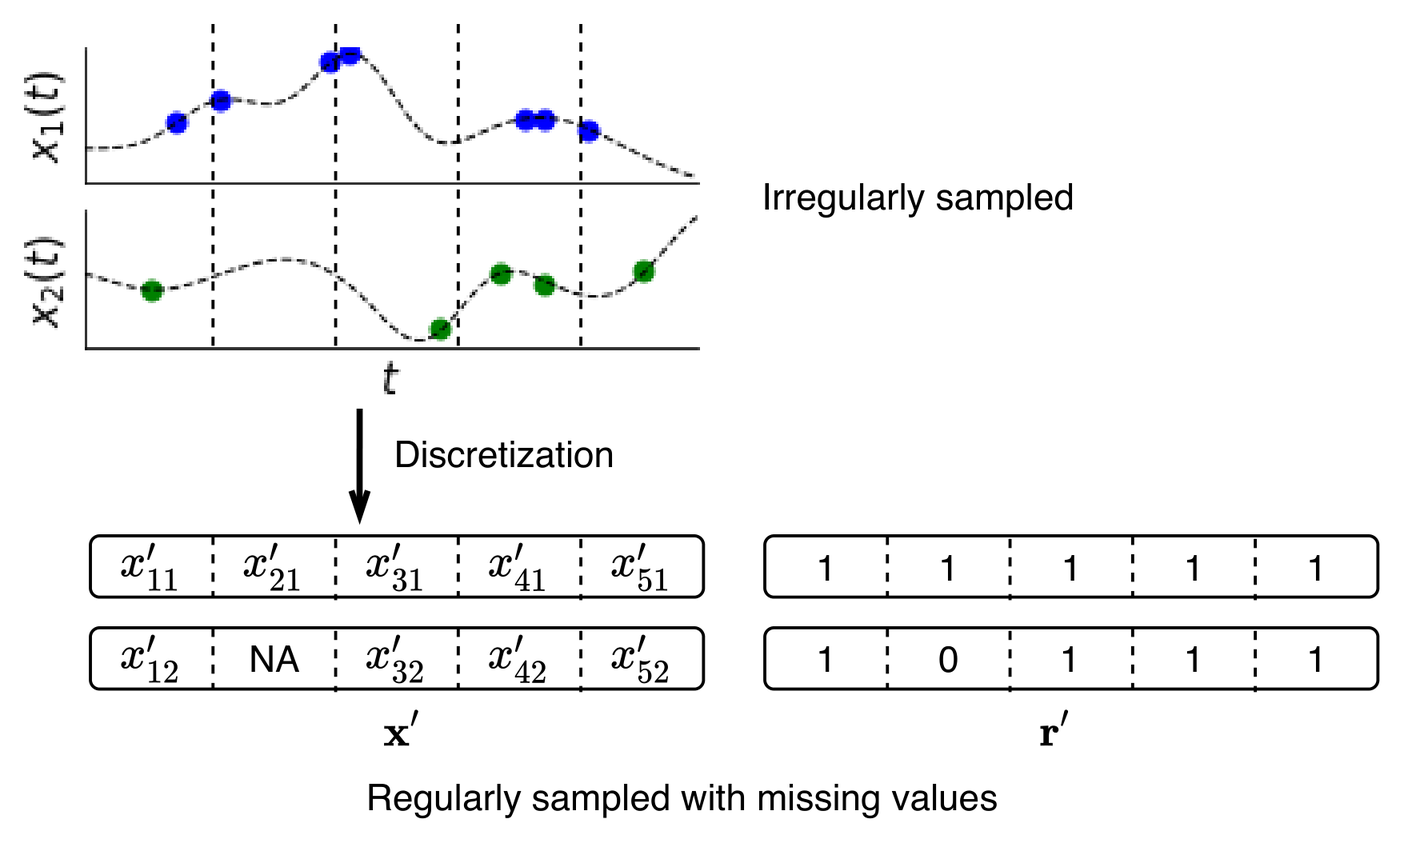
図1: 不規則時系列を等間隔格子へ離散化すると、欠損が生成される(Shukla and Marlin [1], arXiv版 Figure 7 より引用)
図1の下段で x2 の2番目のセルが NA になっているが、この欠損は元のデータに空いていた穴ではない。格子を置いた結果として生まれている [1]。右側の r′ は、どのセルが実測かを示すマスクである。欠損と不規則な観測を混ぜて呼ぶこと自体が悪いのではない。混ぜた瞬間に何かが落ちていることが問題なのである。
落ちるものの中には、観測されたこと自体が持つ情報が含まれる。これを informative missingness(欠損そのものが情報を持つこと)という。
実際、BMJ(医学の主要学術誌)に載った大規模な観察研究は、検査がオーダーされたという事実だけで、結果の値を一切見なくても3年後の生存の見込み(生存オッズ)と有意に関連する検査が272種中233種あったと報告している [2]。測るかどうかの判断そのものが、患者の状態を映している。
実データは本当に不規則なのか
PhysioNet/CinC Challenge 2012 のデータ説明には、観測が「hourly to daily, or at irregular intervals as required」で記録されると書かれている [3]。ただし間隔がどう分布するかまでは示されていないので、学習用データ set-a の 4000 件の ICU 滞在(stay)を自分で数えた。
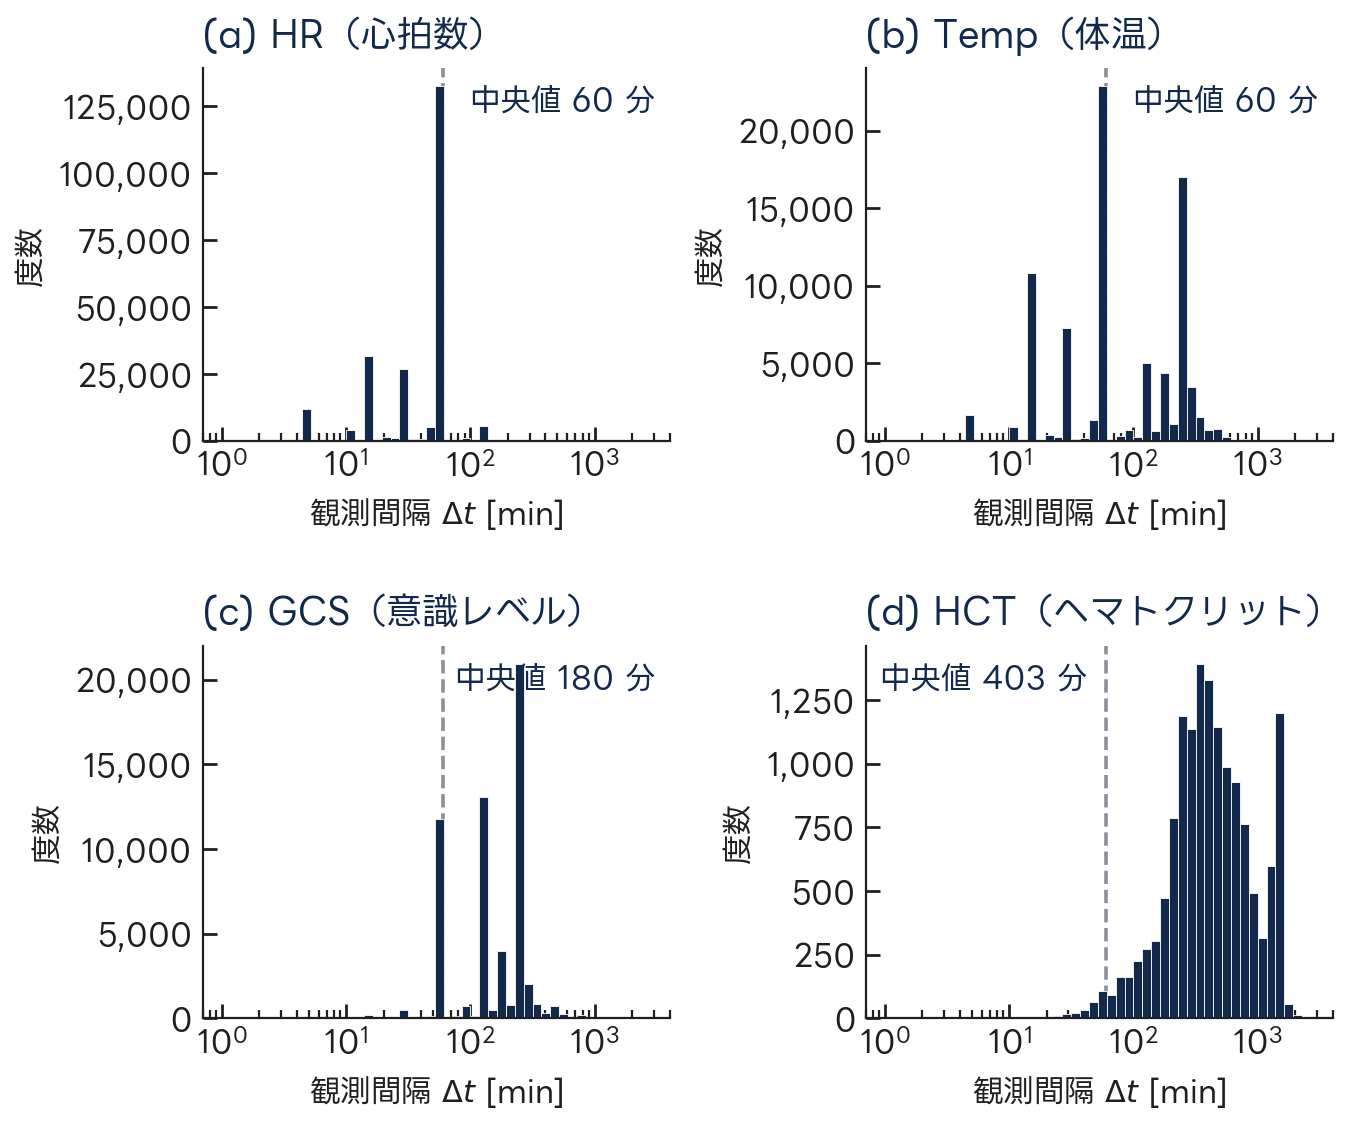
図2: PhysioNet/CinC 2012 set-a の観測間隔の分布。破線が1時間格子(作図)
| パラメータ | 間隔の中央値 | 60分 ± 5分から外れる割合 |
|---|---|---|
| HR(心拍数) | 60分 | 41% |
| Temp(体温) | 60分 | 72% |
| GCS(意識レベル) | 180分 | 80% |
| HCT(ヘマトクリット) | 403分 | 99% |
「1時間格子に載せる」という同じ操作が、パラメータごとにまったく違う意味を持つ。 心拍はほぼ毎時なので、格子はデータの実態に近い。体温は中央値こそ60分だが、4時間側にもう一つの山がある。ヘマトクリットに至っては、間隔の99%が1時間格子から外れる。同じ格子の上に並べた瞬間、心拍は実測、ヘマトクリットはほぼ補間値、という混ぜ物ができあがる。
実務で効いてくるのは、変数をまたいだときである。心拍とヘマトクリットを同じ1時間格子に並べると、両者は同じ時刻に観測された値のように見える。実際には心拍はその時間帯の実測で、ヘマトクリットは7時間前の測定値を引き伸ばしたものかもしれない。格子は、存在しなかった同時性を作り出す。 変数間の相関を見たい場合、この偽の同時性はそのまま偽の相関になる。
小児 ICU のデータでも、バイタルは概ね1時間に1度、採血を要する検査は1日に1度程度である [4]。「多くの実データは等間隔でない」とまでは言えないが、医療の記録、雲のあとの衛星、イベント駆動のセンサに限れば、不規則な観測は例外ではなく普通である。
なぜ「普通のモデル」で予測できないのか
ここで言う「普通のモデル」とは、入力として等間隔に並んだ配列を要求するモデルである。RNN も Transformer も、いま主流の深層学習モデルはこれに当たる。前処理は含めない。不規則時系列を、等間隔化せずにそのまま渡したらどうなるか、という話である。
1分後の次ステップと1日後の次ステップが、同じゲート計算(RNN 内部の更新式)で処理される。
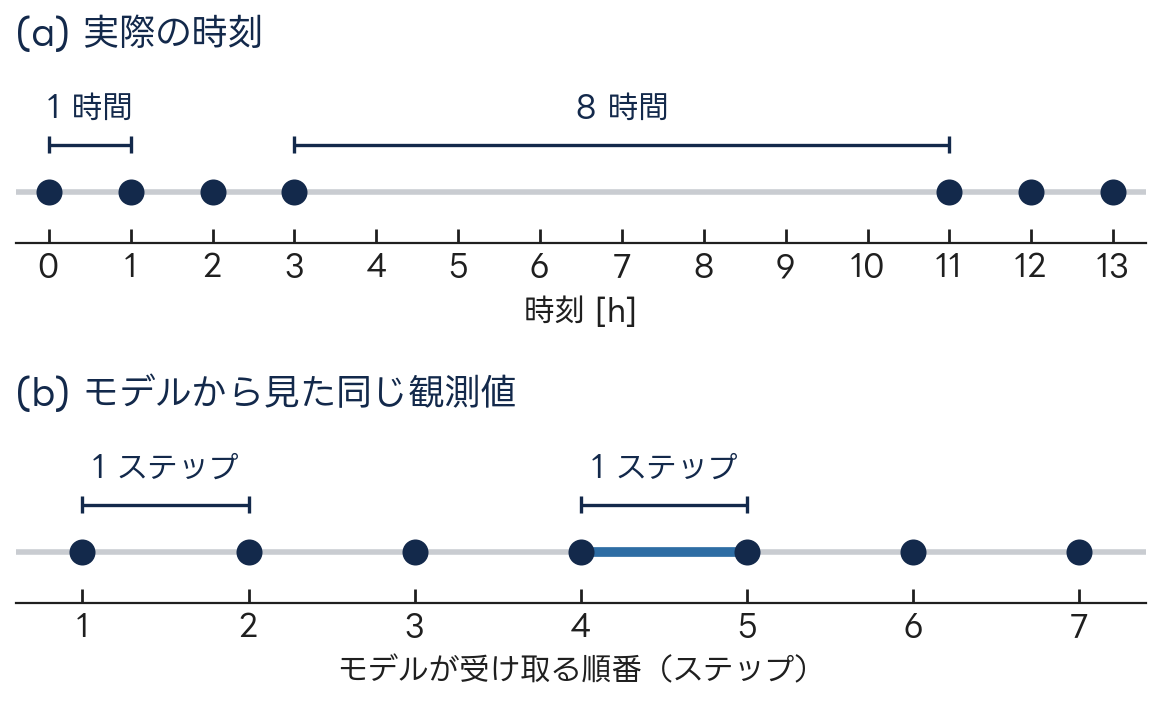
図3: 等間隔を前提にしたモデルは、不規則な観測値をこう受け取る。上が実際の時刻、下がモデルが受け取る順番。8時間の空白も1時間の間隔も、同じ1ステップになる(作図)
図3の8時間の空白のあいだに値がどう動いたかを、モデルは知りようがない。
RNN は「1ステップ = 一定の時間幅」を暗黙に仮定している。Rubanova らはこれを、観測と観測のあいだで隠れ状態が止まっている、と表現している [5]。図3の下段そのものである。図2の節で心拍とヘマトクリットを同じ格子に並べたとき、モデルが見るのもその揃った配列である。
Transformer の位置エンコーディングも同じである。整数の並び順を見ており、実数の時刻は見ていない。不規則時系列に使うなら、連続時刻を埋め込む仕組みを別に足すことになる。
なお、これはいま主流の深層学習モデルの性質であって、時系列モデル一般の性質ではない。Prophet、ガウス過程、連続時間AR(CAR / CARMA)は時刻を実数として扱う設計なので、不規則な入力をそのまま受け付ける。
Δt を足せば足りるのか
素朴な対処は、前回観測からの経過時間 Δt を入力に連結することである。入力の次元が1つ増える。だが観測と観測のあいだで状態がどう進むかは、離散のままである。1分後も1日後も、同じゲート計算だ。
Rubanova らはこれを RNN-Δt としてベースラインに置いた。PhysioNet の補間タスク(欠けた時刻の値を当てるタスク)の結果を抜粋する [5]。↓ は低いほど良い指標で、太字が最良である。
| モデル | 不規則な時刻の扱い | Test MSE (×10⁻³) ↓ |
|---|---|---|
| RNN-Δt | Δt を入力に連結 | 3.520 ± 0.276 |
| GRU-D | 経過時間に応じて状態を減衰 | 3.384 ± 0.274 |
| RNN-Impute | 欠損を埋めて(impute)から RNN に渡す | 3.243 ± 0.275 |
| ODE-RNN | 観測間を微分方程式で進める | 2.361 ± 0.086 |
厳密に同じモデル同士の比較ではないが、Δt を足すだけでは足りない、という方向は出ている。なお、専用モデルの GRU-D は RNN-Impute に負けており(誤差の範囲内ではあるが)、「専用モデルなら常に勝つ」わけでもない。
そのまま渡すと精度はどれくらい落ちるのか
合成データで測った。24時間周期に3時間周期を重ねた波を真値にして、値が低いあいだは頻繁に、高いあいだはまばらに測る、という規則で観測時刻を作った。まばらな区間は、3時間周期の波形が復元できないほど粗い。この観測を、入力の表現だけ変えて同じ GRU(RNN の一種)に渡し、未来の固定時刻の値を当てさせる。乱数を変えて10回(10シード)繰り返した。設定の詳細は記事末に置く。
生の不規則時系列をそのまま渡すと、テスト MSE(平均二乗誤差)は 0.071 ± 0.024 だった。同じ観測を線形補間で等間隔化してから渡すと 0.011 ± 0.005 になる。 平均で6倍強の差だが、倍率より分かりやすいのは分布が重ならないことである。10シードのうち、生の列の最良が 0.038、格子の最悪が 0.018 で、両者は交わらない。観測を一様ランダムにした対照ではさらに開いて 0.312 対 0.012 になる。
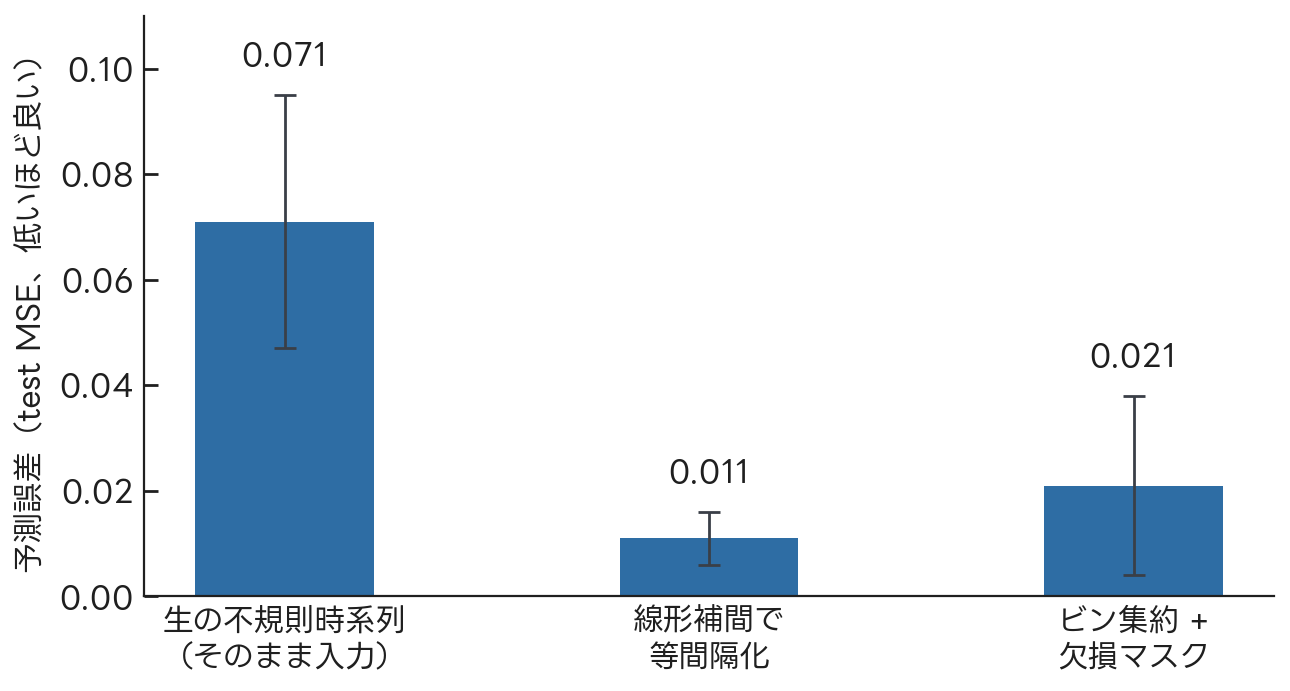
図4: 同じ GRU に入力の表現だけを変えて渡したときの予測誤差(観測が値に依存する系列)。10シードの平均と標準偏差、低いほど良い。ビン集約 + 欠損マスクは収束しなかった1シードを除く(作図)
補間せず、時間帯ごとにまとめて(ビン集約)空セルを欠損マスクで示す条件も測った(図4の右)。収束した9本の平均は 0.021 ± 0.017 で、生のまま渡すよりはるかに良い。要は、等間隔に並んだ配列に載せるかどうかで大きく変わる。補間するかどうかではない。 ただしこの条件は学習が不安定で、10本のうち1本は収束に失敗して 0.26 まで悪化した。
ただし GRU 1種での結果で、6倍という開きはこの合成データと課題設定に固有のものである(さきほどの表では RNN-Δt と RNN-Impute の差は1割程度)。それでも、等間隔の配列を前提にしたモデルに不規則時系列をそのまま入れると精度が落ちる、という方向は動かない。これが、resample が最初に呼ばれる理由である。
等間隔化すると何が起きるか
等間隔化には理由がある。しないと精度が出ない。ではその操作は無害かというと、そうではない。
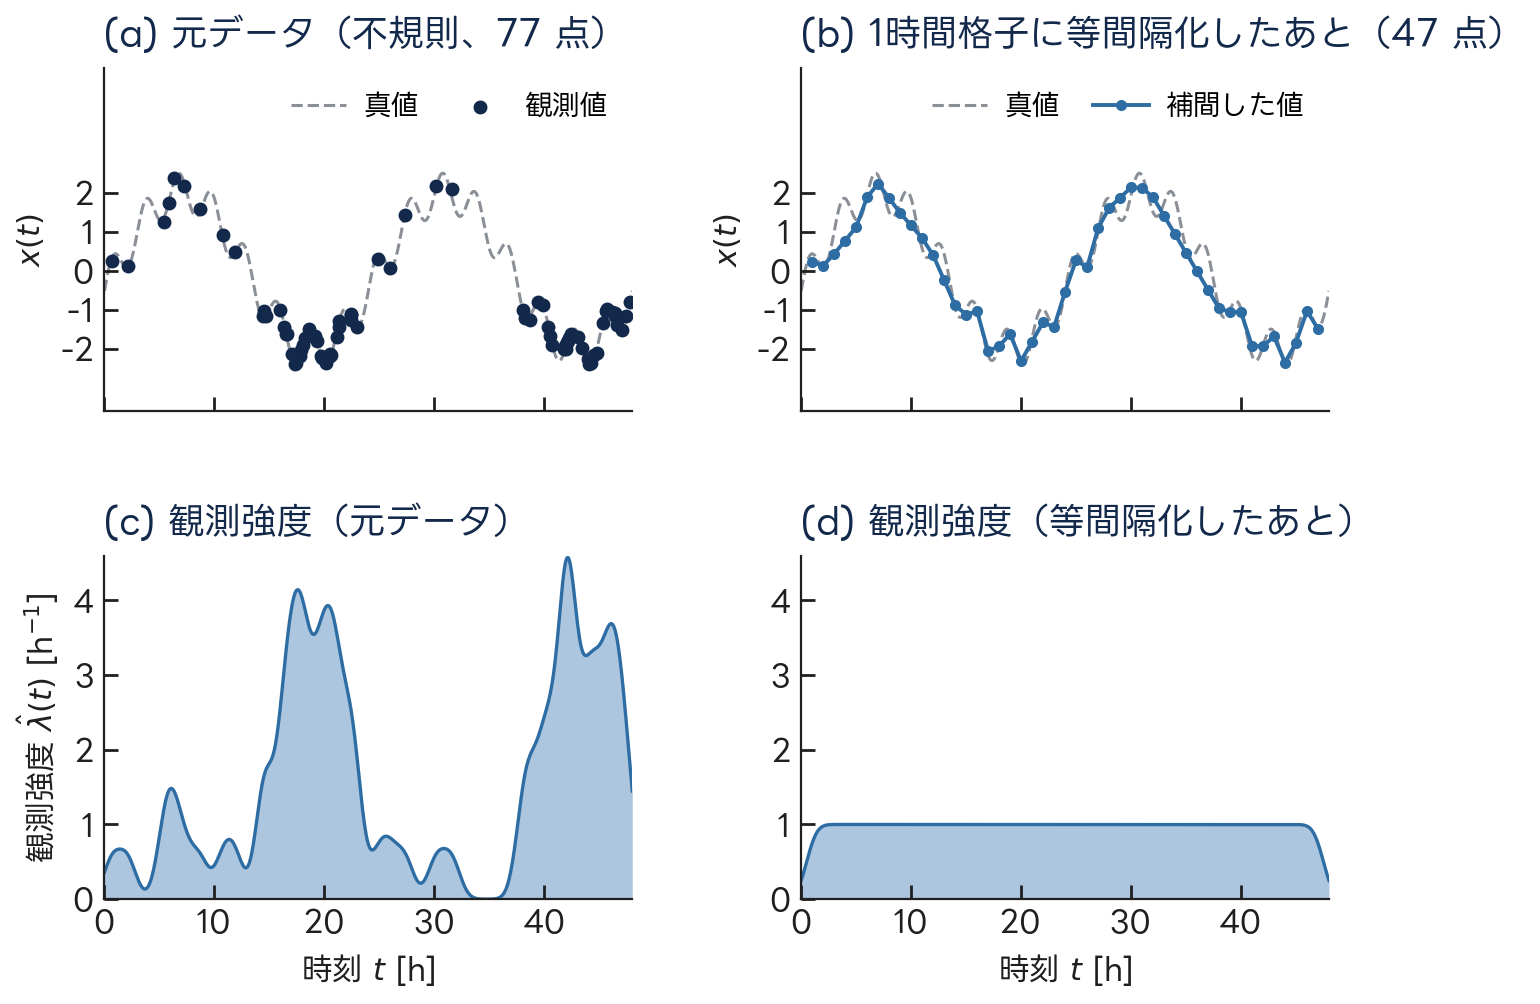
図5: 1時間格子に等間隔化すると何が消えるか。上段が値、下段が観測強度(1時間あたりの観測回数)(作図)
下段の観測強度は、その時刻の周辺で1時間あたり何回測っていたか(測定の密度)である。(c) の2つの丘は「値が低いあいだは頻繁に測る」という規則の痕跡で、丘があること自体が状態を語っている。(d) ではそれが消えて、どの時刻も 1 件/h になる。値の系列は (b) に残るが、測った回数という量は、データから測れなくなっている。
これは合成データの話だが、実データでも同じ操作は起きている。PhysioNet 2012 を扱う既存研究の標準的な前処理は1時間ごとの集約で、Rubanova らはこれを「モデルが観測の 20分の1 しか学習に使えなくなる」と書いている [5]。捨てているのは端数ではない。
等間隔化で足りる場合
ここまでの話は、裏返せば「条件が揃わなければ壊れない」ということでもある。反対側の材料も並べておく。
- 間隔がほぼ等間隔か、見たい現象の時間スケールがギャップより十分長いとき。Rehfeld らの古気候データでは、この条件で線形補間も専用手法も相関推定の結果が同程度だった [6](予測誤差の話ではない点は注意)
- 格子 + 欠損マスクで実用的な精度が出た実績がある。Lipton らは1時間格子に載せた小児 ICU データで、ゼロ埋め + 欠測指標が micro AUC 0.8730、欠測指標のみでも 0.8409 を達成した(分類性能の指標、1.0 が満点) [4]。完全な連続時間化が常に必須なわけではない
そしてもう一つの反証は、本記事の実験そのものである。この実験は「等間隔化すると精度が落ちる」ことを示すつもりで組んだ。結果は逆で、素朴な線形補間で等間隔化したほうが、予測精度は明確に良かった(0.011 対 0.071)。原因は「普通のモデル」の定義に前処理まで含めていたことで、定義をモデル本体に戻して整理し直したのがこの記事である。落ちるのは精度ではなく、いつ測ったかという情報のほうだった。
基盤モデルは解決しているのか
「最近の時系列基盤モデルなら、そのあたりはうまくやってくれるのでは」と思うかもしれない。私も期待していたのだが、提供元の説明を読むと話は逆である。冒頭の補間が、提供元の推奨手順として残っている。
Chronos の論文は、問題設定の段階で「given a uniformly-spaced time series」と等間隔を仮定している [7]。TimesFM の利用手順はもっと直接的だ。文脈は連続していること(穴がないこと)が理想だと述べたうえで、こう書いてある [8]。
In case there are nans we fill in the missing values with linear interpolation before calling the model
提供元が、線形補間してから渡せと書いている。 図5 の (c) を (d) に変える操作を、モデルを作った側が案内しているわけである。等間隔を前提にした設計なのだから一貫してはいるが、不規則時系列は基盤モデルが解いた問題ではない、ということははっきりしている。
まとめ
まずできることは、補間して終わりにせず、観測の有無を残すこと である。格子に載せるにしても、どのセルが実測でどのセルが埋めた値なのかをマスクとしてモデルに渡す。情報を残しても、精度は同じ桁に収まる。
ただしそれは応急処置で、捨てたものを取り戻す方法ではない。捨てずにモデルの側で受け止める設計は、不規則時系列モデルの系譜にまとめている。重い専用モデルが常に要るわけではなく、マスクと経過時間を足した GRU で足りる場面もあるが、進む向きは受け止める側だと私は考えている。
ニューロジカでは、不規則時系列にも対応した時系列基盤モデルを開発している。
付記: 実験の設定
- モデル: GRU(隠れ次元 64、2層)。条件間で構造は同一で、入力の表現だけを変える
- データ: 合成系列 300 本を学習 / 検証 / テストに分割。入力チャネルは学習分割の統計量で標準化
- 学習: 検証誤差による早期終了。乱数シードを変えて 10 回
- 観測時刻: 真値が低いあいだは短い間隔、高いあいだは長い間隔で観測が発生する規則で生成。長い間隔は3時間周期のナイキスト間隔(1.5時間)を超える
- 等間隔化: 格子幅は観測数に合わせた約 0.6 時間。線形補間、またはビン集約 + 欠損マスク
参考文献
- S. N. Shukla, B. M. Marlin. A Survey on Principles, Models and Methods for Learning from Irregularly Sampled Time Series. CoRR arXiv:2012.00168 / NeurIPS 2020 ML Retrospectives arXiv:2012.00168
- D. Agniel, I. S. Kohane, G. M. Weber. Biases in electronic health record data due to processes within the healthcare system. BMJ, 361:k1479, 2018. DOI: 10.1136/bmj.k1479
- I. Silva, G. Moody, D. J. Scott, L. A. Celi, R. G. Mark. Predicting In-Hospital Mortality of ICU Patients: The PhysioNet/Computing in Cardiology Challenge 2012. Computing in Cardiology, 39:245-248, 2012. cinc.org
- Z. C. Lipton, D. C. Kale, R. C. Wetzel. Directly Modeling Missing Data in Sequences with RNNs: Improved Classification of Clinical Time Series. MLHC (PMLR 56:253-270), 2016. PMLR v56
- Y. Rubanova, R. T. Q. Chen, D. Duvenaud. Latent Ordinary Differential Equations for Irregularly-Sampled Time Series. NeurIPS, 2019. arXiv:1907.03907
- K. Rehfeld, N. Marwan, J. Heitzig, J. Kurths. Comparison of correlation analysis techniques for irregularly sampled time series. Nonlinear Processes in Geophysics, 18(3):389-404, 2011. DOI: 10.5194/npg-18-389-2011
- A. F. Ansari et al. Chronos: Learning the Language of Time Series. Transactions on Machine Learning Research (TMLR), 2024. arXiv:2403.07815
- google/timesfm-2.0-500m-pytorch README, Hugging Face(2026-08-22 参照) Hugging Face